PDF का उर्दू में अनुवाद करें
नस्तालीक़ स्क्रिप्ट रेंडरिंग, पूर्ण दाएं-से-बाएं लेआउट मिररिंग, और सही उर्दू-विशिष्ट संयुक्ताक्षर नियमों के साथ PDF को उर्दू में बदलें। आपके दस्तावेज़ लेआउट को संरक्षित करता है। 1 GB तक की फ़ाइलें।
अनुवाद के लिए दस्तावेज़ अपलोड या ड्रॉप करें
अधिकतम फ़ाइल आकार 1 GB
जब आप PDF का उर्दू में अनुवाद करते हैं तो क्या होता है
PDF का उर्दू में अनुवाद करने में तकनीकी चुनौतियों का एक सेट शामिल है जो साधारण पाठ प्रतिस्थापन से परे है। उर्दू नस्तालीक़ में लिखी जाती है, जो फारसी से प्राप्त एक सुलेख शैली है जो तिरछे, कर्सिव पैटर्न में दाएं-से-बाएं बहती है जो अरबी और अधिकांश डिजिटल अरबी-लिपि रेंडरिंग इंजन द्वारा उपयोग की जाने वाली कोणीय नस्क शैली से अलग है। नस्तालीक़ अक्षर जटिल तरीकों से जुड़ते हैं जिनके लिए रेंडरिंग इंजन को उर्दू-विशिष्ट संयुक्ताक्षर नियमों को लागू करने की आवश्यकता होती है, न कि सामान्य अरबी शेपिंग नियमों को। जब कोई PDF रूपांतरण उपकरण उर्दू पाठ पर नस्क शेपिंग लागू करता है, तो आउटपुट तकनीकी रूप से पठनीय लेकिन देशी पाठकों के लिए शैलीगत रूप से गलत लगता है, खासकर औपचारिक और आधिकारिक दस्तावेजों के लिए जहां नस्तालीक़ पाकिस्तान में अपेक्षित मानक है। DocTranslator उचित उर्दू संयुक्ताक्षर हैंडलिंग लागू करता है ताकि अनुवादित आउटपुट टाइपोग्राफिक परंपराओं से मेल खाए जिसकी पाकिस्तानी पाठक उम्मीद करते हैं।
अनुवादित पृष्ठ के लेआउट को स्रोत दस्तावेज़ को प्रतिबिंबित करना चाहिए। उर्दू दाएं-से-बाएं चलती है, जिसका अर्थ है कि कॉलम, पैराग्राफ संरेखण, हेडर स्थिति और तालिका संरचनाओं को अंग्रेजी या अन्य बाएं-से-दाएं स्रोत के सापेक्ष उलटा करने की आवश्यकता है। एक अनुवादित पीडीएफ जहां टेक्स्ट दाएं-से-बाएं चलता है लेकिन कॉलम लेआउट बाएं-से-दाएं रहता है, एक ऐसा दस्तावेज़ तैयार करता है जो भ्रामक और कार्यात्मक रूप से पढ़ने में मुश्किल होता है। पूर्ण RTL मिररिंग वैकल्पिक नहीं है जब लक्षित दर्शक पाकिस्तानी या उर्दू-भाषी प्रवासी पाठक हों जो नस्तालीक रजिस्टर में दस्तावेज़ों का उपभोग करते हैं। लेआउट से परे, उर्दू में अपनी वर्णमाला में 38 अक्षर हैं, जिनमें 4 अक्षर शामिल हैं जो अरबी या फारसी में मौजूद नहीं हैं: महाप्राण और रेट्रोफ्लेक्स व्यंजन जो भाषा के दक्षिण एशियाई ध्वन्यात्मक इतिहास को दर्शाते हैं। इन अतिरिक्त वर्णों को सही ढंग से एन्कोड किया जाना चाहिए या आउटपुट में उन स्थितियों में विकृत या प्रतिस्थापित अक्षर होंगे जहां ये ध्वनियाँ दिखाई देती हैं।
उर्दू के लगभग 70 मिलियन देशी वक्ता हैं और यह पाकिस्तान की राष्ट्रीय भाषा है। यह पांच भारतीय राज्यों: जम्मू और कश्मीर, तेलंगाना, उत्तर प्रदेश, बिहार और पश्चिम बंगाल में भी एक आधिकारिक भाषा है। यूनाइटेड किंगडम में 1.6 मिलियन से अधिक लोगों का पाकिस्तानी प्रवासी समुदाय है, जो इसे दक्षिण एशिया के बाहर उर्दू बोलने वालों का सबसे बड़ा जमावड़ा बनाता है, जिसमें आप्रवासन, रोजगार और पारिवारिक स्थिति के आवेदनों के लिए दोनों दिशाओं में दस्तावेज़ अनुवाद की निरंतर मांग है।
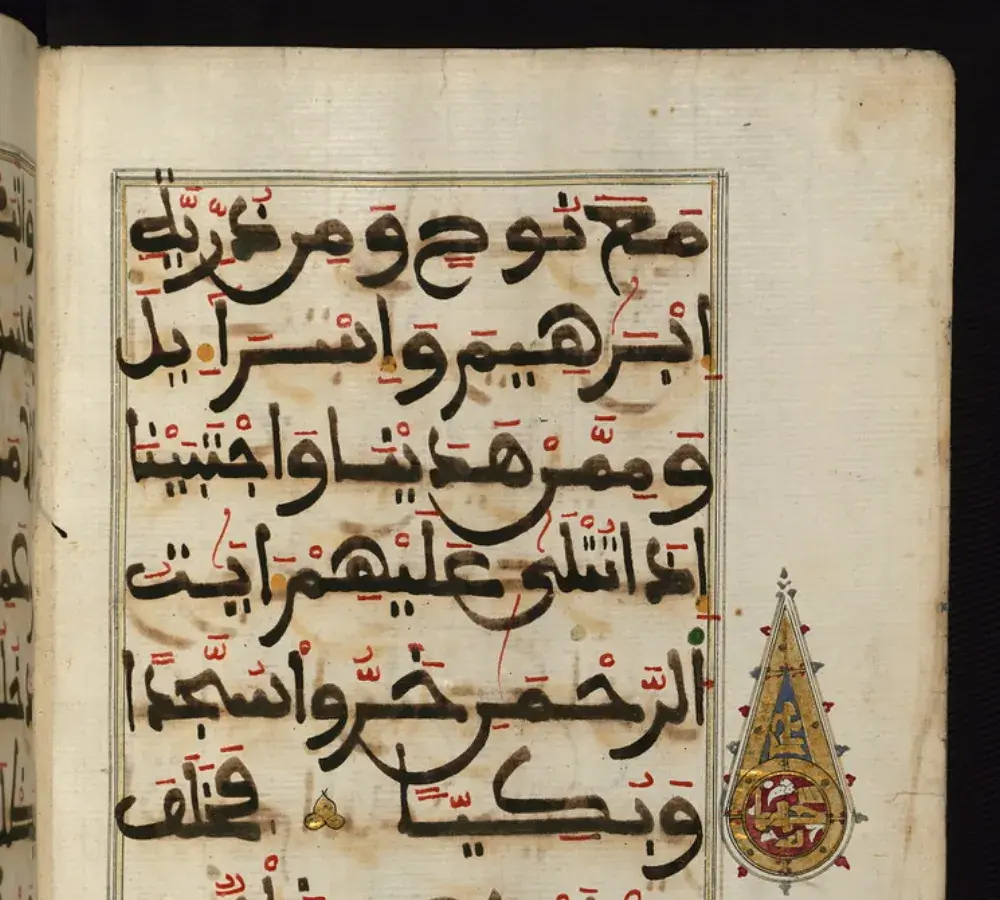
नस्तालीक मानक अरबी डिजिटल रेंडरिंग की तुलना में अधिक जटिल है
अधिकांश डिजिटल अरबी-लिपि रेंडरिंग इंजन नस्क के लिए अनुकूलित हैं, जो अरबी समाचार पत्रों, डिजिटल इंटरफेस और कुरान के सबसे व्यापक रूप से वितरित मुद्रित रूपों में उपयोग की जाने वाली ब्लॉक वाली, सीधी शैली है। नस्तालीक एक मौलिक रूप से अलग सुलेख परंपरा है: अक्षर एक अदृश्य आधार रेखा से लटकते हैं जो दाएं से बाएं नीचे की ओर तिरछे ढलान पर होती है, और अक्षरों के बीच जोड़ने वाले स्ट्रोक ऐसे वक्र और कोणों का पालन करते हैं जिनके लिए ओपनटाइप लिगचर तालिकाओं के एक अलग सेट की आवश्यकता होती है। उर्दू डिजिटल टाइपोग्राफी ऐतिहासिक रूप से अरबी से पीछे रही है क्योंकि नस्तालीक लिगचर तालिकाएं अरबी समकक्षों की तुलना में बहुत बड़ी और अधिक जटिल हैं, और शुरुआती यूनिकोड कार्यान्वयन उर्दू-विशिष्ट वर्णों को पर्याप्त रूप से कवर नहीं करते थे।
नाफीस नस्तालीक, जमील नूरी नस्तालीक और फैज़ लाहौरी नस्तालीक जैसे आधुनिक उर्दू फोंट सही रेंडरिंग प्राप्त करने के लिए हजारों लिगचर संयोजनों को लागू करते हैं। जब एक अनुवादित पीडीएफ इन लिगचर तालिकाओं के बिना एक फ़ॉन्ट एम्बेड करता है, तो टेक्स्ट अलग-अलग अक्षरों में खराब हो जाता है जो ठीक से कनेक्ट नहीं होते हैं, जिससे ऐसा आउटपुट उत्पन्न होता है जिसे कोई भी उर्दू पाठक तैयार दस्तावेज़ के रूप में स्वीकार नहीं करेगा। यह स्वचालित अनुवाद पाइपलाइनों में एक सामान्य विफलता मोड है जो विशेष रूप से नस्तालीक आवश्यकताओं को ध्यान में नहीं रखते हैं। उर्दू औपचारिक रजिस्टर की शब्दावली भी काफी हद तक फारसी और अरबी मूल की है, जो संस्कृत-व्युत्पन्न शब्दावली से बचती है जिसका उपयोग हिंदी उन्हीं अवधारणाओं के लिए करती है, जिसका अर्थ है कि अनुवाद मॉडल को औपचारिक उर्दू रजिस्टर के लिए कैलिब्रेट किया जाना चाहिए न कि एक हाइब्रिड का उत्पादन करने के बजाय जो रजिस्टरों को मिश्रित करता है।
दस्तावेज़ जिन्हें लोग अंग्रेजी और उर्दू के बीच अनुवादित करते हैं
यूके, यूएस, कनाडा और खाड़ी में पाकिस्तानी प्रवासी समुदाय दोनों दिशाओं में उर्दू दस्तावेज़ अनुवाद की निरंतर मांग पैदा करता है। पाकिस्तानी नागरिक जो वीजा के लिए आवेदन कर रहे हैं, पारिवारिक पुनर्मिलन के कागजात जमा कर रहे हैं, या विदेशी शैक्षणिक संस्थानों में नामांकन कर रहे हैं, उन्हें नियमित रूप से उर्दू-भाषा के आधिकारिक दस्तावेजों को अंग्रेजी में प्रस्तुत करने की आवश्यकता होती है। सबसे आम दस्तावेज़ प्रकारों में शामिल हैं:
- यूके और अन्य देशों में वीजा आवेदनों और काम के अधिकार के सत्यापन के लिए पाकिस्तानी सीएनआईसी (कंप्यूटरीकृत राष्ट्रीय पहचान पत्र)
- आप्रवासन और नागरिकता आवेदनों के लिए पाकिस्तानी पासपोर्ट और पाकिस्तान मूल कार्ड
- पारिवारिक वीजा आवेदनों और यूके पति/पत्नी वीजा प्रस्तुतियों के लिए उर्दू-भाषा के जन्म प्रमाण पत्र और निकाहनामा (विवाह प्रमाण पत्र)
- यूके में ईसीटीसीटी (ECCTIS) के साथ क्रेडेंशियल मान्यता और कनाडा और अमेरिका में समकक्षता आकलन के लिए पाकिस्तानी शैक्षणिक डिग्री और प्रतिलेख
- विदेशों में उपचार या बीमा प्रतिपूर्ति की मांग करने वाले प्रवासी रोगियों के लिए उर्दू-भाषा की चिकित्सा रिपोर्ट और अस्पताल से छुट्टी के सारांश
- यूके, यूएई और कनाडाई न्यायालयों में विनिमय या मान्यता के लिए प्रस्तुत पाकिस्तानी ड्राइविंग लाइसेंस
एआई अनुवाद पाकिस्तानी दस्तावेज़ की सामग्री को समझने, समीक्षा के लिए एक कार्य मसौदा तैयार करने, या बड़ी मात्रा में उर्दू टेक्स्ट का तेज़ी से अनुवाद करने के लिए उपयुक्त है। आधिकारिक आप्रवासन प्रस्तुतियाँ, अदालत के कागजात और सरकारी आवेदन आमतौर पर प्रमाणित अनुवाद की आवश्यकता होती है जिसे एक योग्य मानव अनुवादक द्वारा समीक्षा और हस्ताक्षरित किया जाता है। पाकिस्तानी प्रायोजकों या लाभार्थियों से जुड़े यूएससीआईएस (USCIS) याचिकाओं के लिए, यूएससीआईएस (USCIS) अनुवाद आवश्यकताओं पर पूर्ण मार्गदर्शन देखें।
अंग्रेजी से उर्दू पीडीएफ अनुवाद मूल्य निर्धारण
निःशुल्क साइन अप करें, प्रति दस्तावेज़ भुगतान करें, और जैसे-जैसे आपकी अनुवाद ज़रूरतें बढ़ती हैं, अपग्रेड करें।
Free
साइन अप करने के लिए कार्ड की आवश्यकता नहीं है
- $0.005/शब्द AI अनुवाद
- स्कैन और इमेज PDF के लिए $1 प्रति पृष्ठ
- 120+ भाषाएँ
- 20 MB और 20 पृष्ठों तक की फ़ाइलें
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- केवल 24-घंटे फ़ाइल स्टोरेज
- PDF संपादक और PDF से DOCX कनवर्टर
- कभी भी रद्द करें
- शामिल नहीं: ईमेल सहायता
- शामिल नहीं: टीम एक्सेस
- शामिल नहीं: असीमित मुफ्त PDF पूर्वावलोकन
- शामिल नहीं: शब्दावली
Storage
या $149/वर्ष
- $0.005/शब्द AI अनुवाद
- स्कैन और इमेज PDF के लिए $1 प्रति पृष्ठ
- 120+ भाषाएँ
- 100 MB और 100 पृष्ठों तक की फ़ाइलें
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- असीमित फ़ाइल संग्रहण
- PDF संपादक और PDF से DOCX कनवर्टर
- ईमेल सहायता
- कभी भी रद्द करें
- शामिल नहीं: टीम एक्सेस
- शामिल नहीं: असीमित मुफ्त PDF पूर्वावलोकन
- शामिल नहीं: शब्दावली
Pro
या $499/वर्ष
- $0.004/शब्द AI अनुवाद
- स्कैन और इमेज PDF के लिए $0.80 प्रति पृष्ठ
- 120+ भाषाएँ
- 1,000 MB और 5,000 पृष्ठों तक की फ़ाइलें
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- असीमित फ़ाइल संग्रहण
- PDF संपादक और PDF से DOCX कनवर्टर
- ईमेल सहायता
- 5 सदस्यों तक के लिए टीम एक्सेस
- असीमित मुफ्त PDF पूर्वावलोकन
- शब्दावली
- कभी भी रद्द करें
एंटरप्राइज
$149.99/माह, अनुरोध पर। $0.003/शब्द पर AI अनुवाद ($0.60 प्रति पृष्ठ), 1,000 MB और 5,000 पृष्ठों तक की फ़ाइलें, असीमित फ़ाइल स्टोरेज और 15 सदस्यों तक के लिए टीम एक्सेस।
अपने पीडीएफ का उर्दू में अनुवाद कैसे करें
एक मुफ़्त खाता बनाएँ
ऑनलाइन अनुवाद डैशबोर्ड तक पहुँचने के लिए अपने ईमेल के साथ साइन अप करें।
अपनी PDF फ़ाइल अपलोड करें
अपनी फ़ाइल को ड्रैग और ड्रॉप करें या उसे चुनने के लिए ब्राउज़ करें। Pro और Enterprise प्लान पर 1,000 MB तक की फ़ाइलें समर्थित हैं।
उर्दू को लक्ष्य भाषा के रूप में चुनें
अपने पीडीएफ की मूल भाषा चुनें और उर्दू को लक्ष्य भाषा के रूप में सेट करें। आउटपुट नस्तालीक स्क्रिप्ट रेंडरिंग को पूर्ण आरटीएल (RTL) लेआउट मिररिंग और सही उर्दू-विशिष्ट लिगचर हैंडलिंग के साथ लागू करेगा।
अनुवाद और डाउनलोड करें
"अनुवाद करें" पर क्लिक करें और कुछ क्षण प्रतीक्षा करें। आपकी अनुवादित पीडीएफ मूल लेआउट को दाएं-से-बाएं प्रारूप में संरक्षित रखते हुए उर्दू में डाउनलोड के लिए तैयार हो जाएगी।
अंग्रेजी से उर्दू पीडीएफ अनुवाद अक्सर पूछे जाने वाले प्रश्न
नस्तालीक़ अरबी-लिपि से कैसे भिन्न है जिसका उपयोग अरबी-भाषा PDF में किया जाता है?
नस्तालीक़ और नस्क दोनों अरबी-लिपि शैलियाँ हैं, लेकिन वे बहुत अलग ढंग से प्रस्तुत होती हैं। नस्क सीधा और कोणीय होता है, और अधिकांश डिजिटल रेंडरिंग इंजन इसके लिए अनुकूलित होते हैं क्योंकि अरबी, फ़ारसी और अधिकांश दक्षिण एशियाई लिपि प्रसंस्करण ने ऐतिहासिक रूप से डिजिटल संदर्भों में नस्क का उपयोग किया है। नस्तालीक़ तिरछा और सुलेखक होता है, जिसमें अक्षर एक अदृश्य ढलान वाली आधार रेखा के नीचे लटकते हैं। इसके लिए ओपनटाइप लिगचर तालिकाओं के एक अलग सेट की आवश्यकता होती है जो नस्क समकक्षों की तुलना में बहुत बड़े और अधिक जटिल होते हैं। उर्दू पाठ पर नस्क शेपिंग नियमों को लागू करने से आउटपुट उत्पन्न होता है जो तकनीकी रूप से पठनीय है लेकिन पाकिस्तानी पाठकों के लिए नेत्रहीन रूप से अस्वीकार्य है। DocTranslator सामान्य अरबी शेपिंग पर डिफ़ॉल्ट होने के बजाय उर्दू-विशिष्ट नस्तालीक़ लिगचर नियमों को लागू करता है।
क्या अनुवादित PDF पूर्ण राइट-टू-लेफ्ट लेआउट मिररिंग का समर्थन करता है?
हाँ। उर्दू एक राइट-टू-लेफ्ट भाषा है, जिसका अर्थ है कि पृष्ठ लेआउट, कॉलम क्रम, पैराग्राफ संरेखण और तालिका संरचनाओं को एक लेफ्ट-टू-राइट स्रोत दस्तावेज़ के सापेक्ष प्रतिबिंबित करने की आवश्यकता है। एक PDF जहां पाठ दिशा सही है लेकिन कॉलम लेआउट उलट नहीं है, उर्दू पाठकों के लिए भटकाव पैदा करने वाला दस्तावेज़ उत्पन्न करता है। DocTranslator पूर्ण RTL लेआउट मिररिंग को संभालता है ताकि अनुवादित दस्तावेज़ का संरचनात्मक प्रवाह उर्दू पढ़ने की परंपराओं से मेल खाता हो।
अरबी या फ़ारसी में न पाए जाने वाले 4 उर्दू अक्षर कौन से हैं?
उर्दू में 38 अक्षर हैं। उनमें से चार उर्दू के लिए अद्वितीय हैं और अरबी या फ़ारसी में नहीं पाए जाते हैं: एस्पिरेटेड रेट्रोफ्लेक्स स्टॉप और फ्रिकेटिव जो दक्षिण एशियाई ध्वन्यात्मक ध्वनियों का प्रतिनिधित्व करते हैं जिनका अरबी या फ़ारसी ध्वन्यात्मकता में कोई समकक्ष नहीं है। इनमें एस्पिरेटेड रेट्रोफ्लेक्स डी और टी जैसी ध्वनियों के लिए अक्षर शामिल हैं, जो दक्षिण एशियाई मूल के शब्दों में अक्सर दिखाई देते हैं जो क्षेत्रीय भाषाओं के साथ संपर्क के माध्यम से उर्दू में प्रवेश करते हैं। इन वर्णों को सही यूनिकोड कोड पॉइंट के साथ एन्कोड किया जाना चाहिए या वे अनुवादित PDF में प्रतिस्थापन वर्णों या विकृत आउटपुट के रूप में दिखाई देते हैं।
औपचारिक उर्दू संस्कृत-व्युत्पन्न शब्दों के बजाय फ़ारसी और अरबी शब्दावली का उपयोग क्यों करती है?
उर्दू और हिंदी समान बोली जाने वाली व्याकरण और रोजमर्रा की संवादी शब्दावली साझा करते हैं, लेकिन वे धार्मिक और सांस्कृतिक आधार पर अपने औपचारिक लिखित रजिस्टरों में भिन्न हो गए। औपचारिक उर्दू मुगल दरबार संस्कृति और इस्लामी साहित्यिक परंपरा के प्रभाव को दर्शाते हुए फ़ारसी और अरबी से अपनी प्रतिष्ठा शब्दावली प्राप्त करती है। हिंदी औपचारिक रजिस्टर समान अवधारणाओं के लिए संस्कृत-व्युत्पन्न शब्दावली का उपयोग करता है। एक अनुवाद मॉडल जो हिंदी और उर्दू को मिलाता है या गलत रजिस्टर का उपयोग करता है, वह पाठ उत्पन्न करेगा जो तकनीकी रूप से सही लेकिन सांस्कृतिक रूप से गलत संरेखित है। पाकिस्तानी सरकारी दस्तावेज़ या पत्राचार प्राप्त करने वाले उर्दू भाषी संस्कृत-व्युत्पन्न विकल्पों के बजाय फ़ारसी-अरबी औपचारिक रजिस्टर की अपेक्षा करते हैं।
यूके आप्रवासन उद्देश्यों के लिए सबसे अधिक बार किन पाकिस्तानी पहचान दस्तावेज़ों का अनुवाद किया जाता है?
यूके आप्रवासन के लिए सबसे अधिक बार अनुवादित पाकिस्तानी दस्तावेज़ सीएनआईसी (कंप्यूटरीकृत राष्ट्रीय पहचान पत्र), पाकिस्तानी पासपोर्ट, निकाहनामा (इस्लामी विवाह प्रमाण पत्र), और पाकिस्तान नगरपालिका प्राधिकरणों जैसे NADRA या यूनियन काउंसिल कार्यालयों द्वारा जारी जन्म प्रमाण पत्र हैं। 1.6 मिलियन से अधिक का यूके पाकिस्तानी प्रवासी समुदाय पति/पत्नी वीजा आवेदनों, पारिवारिक पुनर्मिलन, वंशानुगत नागरिकता और काम के अधिकार के सत्यापन के संदर्भ में इन दस्तावेजों की स्थिर मांग पैदा करता है। आधिकारिक यूके गृह कार्यालय प्रस्तुतियों के लिए, एआई मसौदे के बजाय प्रमाणित अनुवाद की आवश्यकता होती है।
क्या मैं उर्दू से अंग्रेज़ी और अंग्रेज़ी से उर्दू में भी अनुवाद कर सकता हूँ?
हाँ। उर्दू-अंग्रेज़ी जोड़ी दोनों दिशाओं में काम करती है। उर्दू पीडीएफ का अंग्रेज़ी में अनुवाद करना प्रवासी सदस्यों के लिए पाकिस्तान के दस्तावेज़ों को यूके, यूएस, या कनाडा के अधिकारियों, नियोक्ताओं, या शैक्षणिक संस्थानों के साथ साझा करने की अधिक सामान्य दिशा है। अंग्रेज़ी का उर्दू में अनुवाद करना उन कंपनियों के लिए आम है जो पाकिस्तानी कर्मचारियों या ग्राहकों को सामग्री वितरित करती हैं, पाकिस्तान में काम करने वाले एनजीओ के लिए, और सरकारी एजेंसियों के लिए जो यूके में उर्दू भाषी समुदायों या भारत के उन पाँच राज्यों के लिए दस्तावेज़ तैयार करती हैं जहाँ उर्दू की आधिकारिक स्थिति है।
मैं कितनी बड़ी उर्दू पीडीएफ का अनुवाद कर सकता हूँ?
Pro और Enterprise पर 1,000 MB या 5,000 पृष्ठों तक, Storage पर 100 MB और 100 पृष्ठों तक, और Free पर 20 MB और 20 पृष्ठों तक। पहले एक छोटा नमूना अनुवाद करने की लागत $0.99 से शुरू होती है और यह सत्यापित करने के लिए पर्याप्त है कि नस्तालीक रेंडरिंग, RTL लेआउट मिररिंग, और उर्दू-विशिष्ट संयुक्ताक्षर हैंडलिंग को पाकिस्तानी पासपोर्ट या अकादमिक प्रतिलेख जैसे पूर्ण दस्तावेज़ के लिए प्रतिबद्ध होने से पहले एक नमूने पर सही हैं।
आज ही अपने पीडीएफ का उर्दू में अनुवाद करें
DocTranslator पीडीएफ को ऑनलाइन उर्दू में परिवर्तित करता है, नस्तालीक स्क्रिप्ट रेंडरिंग को पूर्ण आरटीएल (RTL) लेआउट मिररिंग, सही उर्दू-विशिष्ट लिगचर नियमों और उर्दू के लिए अद्वितीय 4 सहित सभी 38 उर्दू अक्षरों के समर्थन के साथ लागू करता है। 1 जीबी तक की फाइलें।
संबंधित उपकरण
भाषा के अनुसार PDF का अनुवाद करें
दस्तावेज़ प्रकार
फ़ाइल प्रारूप
हमारे भागीदार