CSV अनुवादक
उत्पाद कैटलॉग, निर्यात और डेटासेट कॉलम दर कॉलम अनुवादित, डेलिमिटर, कोटिंग और पहचानकर्ता कॉलम के साथ ठीक वैसे ही छोड़े जाते हैं जैसा आपका पार्सर उन्हें खोजने की उम्मीद करता है।
अनुवाद के लिए दस्तावेज़ अपलोड या ड्रॉप करें
अधिकतम फ़ाइल आकार 1 GB Pro और Business पर
यह बटन मुफ़्त साइन-अप खोलता है। अनुवाद स्वयं आपके डैशबोर्ड में चलता है, जहाँ आप फ़ाइल को फिर से चुनते हैं। AI सहायक का उपयोग कर रहे हैं? MCP के माध्यम से इसे कनेक्ट करें।
- स्कैन और फ़ोटो के लिए OCR
- 108 भाषाएँ
- मूल लेआउट रखा गया
संरचना दो वर्णों द्वारा समर्थित है
कॉमा-सेपरेटेड वैल्यूज़ (CSV) शायद ही कोई प्रारूप है। एक व्यापक रूप से पालन किया जाने वाला सामान्य बोली का विवरण है, लेकिन कोई प्राधिकरण इसे लागू नहीं करता है, इसलिए आपको वास्तव में जो मिलता है वह कई परंपराओं में से एक है। पूरा ग्रिड दो निर्णयों पर टिका है: कौन सा वर्ण किसी रिकॉर्ड में फ़ील्ड को अलग करता है, और कौन सा क्रम एक रिकॉर्ड को समाप्त करता है। किसी एक को भी गलत करें और एक साफ-सुथरी तालिका एक ही बेढंगी कॉलम बन जाती है।
सेपरेटर हमेशा कॉमा नहीं होता है। उन देशों में स्प्रेडशीट सॉफ़्टवेयर जो कॉमा के साथ दशमलव लिखते हैं, डिफ़ॉल्ट रूप से इसके बजाय सेमीकोलन का उपयोग करते हैं, यही कारण है कि जर्मन या फ्रेंच मशीन से निर्यात अक्सर कहीं और सफाई से नहीं खुलता है। टैब और वर्टिकल बार दोनों सामान्य उपयोग में हैं, आमतौर पर इसलिए चुने जाते हैं क्योंकि सामग्री कॉमा से भरी होती है।
प्रत्येक रिकॉर्ड में हेडर के समान फ़ील्ड की संख्या होनी चाहिए, क्योंकि वह गणना ही है जिससे पार्सर को पता चलता है कि कौन सा मान किस कॉलम से संबंधित है। डेटा में कुछ भी इसकी घोषणा नहीं करता है। यह एक अपरिवर्तनीय है जो या तो बना रहता है या एक बड़े निर्यात के बीच में चुपचाप बना रहना बंद कर देता है, जिस बिंदु पर नीचे सब कुछ एक कॉलम बाईं ओर खिसक जाता है और विश्वसनीय लगता है।
चार तरीके जिनसे अनुवादित टेक्स्ट एक रिकॉर्ड को तोड़ता है
ये वे विफलताएँ हैं जो खुद को घोषित नहीं करती हैं। निर्यात अभी भी खुलता है, पंक्ति गणना अभी भी मोटे तौर पर सही लगती है, और क्षति बाद में डेटा का उपभोग करने वाली किसी भी चीज़ में दिखाई देती है।
- एक नया सेपरेटर मान के अंदर दिखाई देता है। बिना कॉमा वाले अंग्रेजी उत्पाद विवरण में दो कॉमा वाला फ्रेंच विवरण बन जाता है। यदि फ़ील्ड पहले उद्धृत नहीं किया गया था, तो अब इसे करना होगा, या पार्सर एक मान को तीन के रूप में पढ़ता है और उसके बाद के हर कॉलम को स्थानांतरित कर देता है।
- एक उद्धरण चिह्न उद्धृत मान के अंदर आता है। संलग्न फ़ील्ड के अंदर, एक शाब्दिक डबल कोट को स्वयं से बचने के लिए दो बार लिखा जाना चाहिए। विभिन्न चिह्नों के साथ उद्धृत करने वाली भाषाएँ, और सीधी चिह्नों को टाइपोग्राफ़िक चिह्नों में बदलने वाली कोई भी प्रक्रिया, एक अनएस्केप्ड कैरेक्टर को मान के बीच में छोड़ सकती है जहाँ यह फ़ील्ड को जल्दी समाप्त कर देता है।
- एक लाइन ब्रेक सेल में रेंगता है। एक रिकॉर्ड नई लाइन पर समाप्त होता है जब तक कि वह नई लाइन उद्धरणों के अंदर न हो। पैराग्राफ ब्रेक प्राप्त करने वाली अनुवादित मार्केटिंग कॉपी एक रिकॉर्ड को दो में विभाजित कर देगी, और दूसरे आधे में फ़ील्ड की गलत संख्या होगी।
- एक प्लेसहोल्डर का अनुवाद हो जाता है। सॉफ़्टवेयर के लिए नियत स्ट्रिंग्स में अक्सर प्रतिस्थापन टोकन होते हैं, एक प्रतिशत चिह्न जिसके बाद एक अक्षर होता है, कोष्ठक में एक क्रमांकित स्लॉट, एक नामित चर। वे रनटाइम पर डाले गए मानों के लिए पते हैं, शब्द नहीं, और एक का अनुवाद करने का मतलब है कि मान कभी दिखाई नहीं देता है।
आपके आधे कॉलम भाषा नहीं हैं
एक डेटासेट मनुष्यों के लिए अभिप्रेत गद्य को मशीनों के लिए अभिप्रेत कुंजियों के साथ मिलाता है, और वे अगल-बगल बैठे होते हैं जिनमें उन्हें अलग करने के लिए कुछ भी नहीं होता है सिवाय कॉलम हेडिंग के। शुरू करने से पहले काम करें कि कौन सा क्या है, क्योंकि एक अनुवादित पहचानकर्ता एक अनअनुवादित विवरण से भी बदतर है।
इन्हें अकेला छोड़ दें
- हेडर पंक्ति स्वयं जहाँ हेडिंग फ़ील्ड नाम हैं जिनका उपयोग कोड द्वारा किया जाता है न कि किसी व्यक्ति को दिखाए गए लेबल के रूप में
- स्टॉक कोड, कैटलॉग नंबर, अद्वितीय पहचानकर्ता और किसी भी कुंजी का उपयोग दो डेटासेट को जोड़ने के लिए किया जाता है
- वेब पते और उनमें से स्लग भाग, क्योंकि इसे बदलने से लिंक और उसकी रैंकिंग टूट जाती है
- स्थिति मान जिनकी तुलना सॉफ़्टवेयर एक निश्चित सूची से करता है, जैसे ऑर्डर स्थिति या हाँ-और-नहीं फ़्लैग
- देश, भाषा और मुद्रा कोड, जो पहले से ही मानकीकृत संक्षिप्ताक्षर हैं
- साल-महीना-दिन के क्रम में लिखी गई तारीखें, संख्याएँ, और कुछ भी जिसे पढ़ा जाने के बजाय पार्स किया जाएगा
ये वही हैं जिनके लिए आप आए थे
- उत्पाद शीर्षक और लंबे विवरण, जो आमतौर पर शब्द गणना का अधिकांश हिस्सा होते हैं
- श्रेणी और संग्रह के नाम जैसा कि ग्राहक उन्हें देखते हैं
- अर्थ वाले विशेषता मान, जैसे रंग, सामग्री या आकार का शब्द
- स्थानीयकरण के लिए निकाले गए इंटरफ़ेस स्ट्रिंग, उनके प्लेसहोल्डर को छोड़कर
- समर्थन लेख निकाय, पूर्वनिर्धारित उत्तर और ईमेल टेम्प्लेट पंक्तियों के रूप में रखे गए
- कॉलम हेडिंग जहाँ निर्यात किसी व्यक्ति द्वारा पढ़ा जाना है न कि किसी प्रोग्राम द्वारा
दो चीजें जो अनुवाद शुरू होने से पहले डेटा को नुकसान पहुँचाती हैं
इसे स्प्रेडशीट में खोलना
निर्यात को डबल-क्लिक करके और उसे फिर से सहेजना एक कैटलॉग को भ्रष्ट करने का सबसे विश्वसनीय तरीका है। स्प्रेडशीट सॉफ़्टवेयर हर मान के प्रकार का अनुमान लगाता है जिसे वह देखता है, और उसके अनुमान आत्मविश्वासी और गलत होते हैं:
- तेरह अंकों की एक लेख संख्या वैज्ञानिक संकेतन में बदल जाती है और उसके अंतिम अंक हमेशा के लिए खो जाते हैं
- शून्य से शुरू होने वाला एक डाक कोड शून्य खो देता है
- दिन और महीने के समान दिखने वाली किसी भी चीज़ को स्थानीय प्रारूप में एक तिथि के रूप में फिर से लिखा जाता है
- पंद्रह अंकों से आगे के लंबे पहचानकर्ता, चुपचाप, गोल किए जाते हैं
यदि आपको पहले डेटा का निरीक्षण करना है, तो आयात संवाद का उपयोग करें और पहचानकर्ता कॉलम को टेक्स्ट पर सेट करें बजाय इसके कि प्रोग्राम को तय करने दें। इससे भी बेहतर, अपने सिस्टम द्वारा उत्पादित निर्यात को ठीक वैसे ही अपलोड करें।
बाइट ऑर्डर मार्क प्रश्न
डेटा के अंदर कुछ भी यह नहीं कहता है कि यह किस कैरेक्टर एन्कोडिंग का उपयोग करता है, इसलिए तीन बाइट्स का एक मार्कर कभी-कभी एक को इंगित करने के लिए बहुत शुरुआत में रखा जाता है। वह मार्कर मदद करता है और नुकसान पहुँचाता है, इस पर निर्भर करता है कि डेटा को आगे क्या खोलता है।
विंडोज पर स्प्रेडशीट सॉफ़्टवेयर इसका उपयोग यूनिकोड सामग्री को पहचानने के लिए करता है, और इसके बिना एक्सेंटेड और गैर-लैटिन वर्ण प्रतीकों की स्ट्रिंग के रूप में बाहर आते हैं। इसके विपरीत, कई प्रोग्रामिंग लाइब्रेरी इसे हटाती नहीं हैं, इसलिए पहला कॉलम हेडिंग तीन अदृश्य वर्णों के साथ सामने आता है और उस हेडिंग के विरुद्ध हर लुकअप विफल हो जाता है।
गंतव्य के अनुसार निर्णय लें: यदि कोई व्यक्ति परिणाम को स्प्रेडशीट में खोलेगा तो मार्कर रखें, यदि कोई प्रोग्राम इसे पढ़ेगा तो इसे छोड़ दें। भ्रष्ट एक्सेंटेड वर्णों के बारे में लगभग हर प्रश्न का उत्तर इस पैराग्राफ में कहीं न कहीं है।
डेटासेट को प्रोसेस करने की लागत क्या है
पाठ की मात्रा के अनुसार मूल्य निर्धारित, इसलिए छोटे मानों वाले एक विस्तृत कैटलॉग लंबे विवरणों से भरे एक संकीर्ण कैटलॉग की तुलना में सस्ता है।
Free
साइन अप करने के लिए कार्ड की आवश्यकता नहीं है
- $0.005/शब्द AI अनुवाद
- प्रति पृष्ठ $1, PDF और स्कैन के लिए
- पहले पृष्ठ का निःशुल्क पूर्वावलोकन, जहाँ उपलब्ध हो
- 108 भाषाएँ
- 20 MB और 20 पृष्ठों तक की फ़ाइलें
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- केवल 24-घंटे फ़ाइल स्टोरेज
- PDF संपादक और PDF से DOCX कनवर्टर
बुनियादी
सबसे लोकप्रियहर हफ्ते बिल · कभी भी रद्द करें
मासिक बिल
एक साल में बिल · 33% बचाएं
- एआई अनुवाद हर महीने शामिल
- फिर $0.005/शब्द एआई अनुवाद
- 100 एमबी तक की फाइलें और 300 पेज
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- स्कैन किए गए दस्तावेज़ों के लिए OCR
- दस्तावेज़ भंडारण
- प्राथमिकता सहायता
- मासिक योजना पर 7-दिवसीय निःशुल्क परीक्षण, 30,000 शब्दों तक
- कभी भी रद्द करें
Pro
मासिक बिल
एक साल में बिल · 34% बचाएं
- एआई अनुवाद हर महीने शामिल
- फिर $0.004/शब्द एआई अनुवाद
- 1 जीबी तक की फाइलें और 5,000 पेज
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- शब्दावली
- प्राथमिकता कतार
- 5 टीम सीटें
- API अनुरोध · 1,000 पेज प्रति माह
- एआई सहायकों के लिए MCP एक्सेस
- कभी भी रद्द करें
व्यावसायिक
मासिक बिल
एक साल में बिल · 33% बचाएं
- एआई अनुवाद हर महीने शामिल
- फिर $0.003/शब्द एआई अनुवाद
- 1 जीबी तक की फाइलें और 5,000 पेज
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG और CSV
- शब्दावली
- प्राथमिकता कतार
- 15 टीम सीटें
- API अनुरोध · 5,000 पेज प्रति माह
- एआई सहायकों के लिए MCP एक्सेस
- कभी भी रद्द करें
एंटरप्राइज
अधिक मात्रा, चालान या कस्टम समझौते की आवश्यकता है? Enterprise योजना के बारे में हमसे बात करें।
पंक्तियाँ अंदर, पंक्तियाँ बाहर
एक थंबनेल को बड़ा करके एक स्रोत पृष्ठ की उसके परिणाम से तुलना करें। जोड़े क्या दर्शाते हैं:
- प्रति रिकॉर्ड कॉलम गणना ऊपर से नीचे तक अपरिवर्तित रहती है।
- उद्धरण चिह्नों में संलग्न मान अभी भी संलग्न हैं।
- कोड, कुंजियाँ और संख्यात्मक मान बिना छुए गुजरते हैं।
- केवल मानव-पठनीय कॉलम एक नई भाषा में वापस आते हैं।
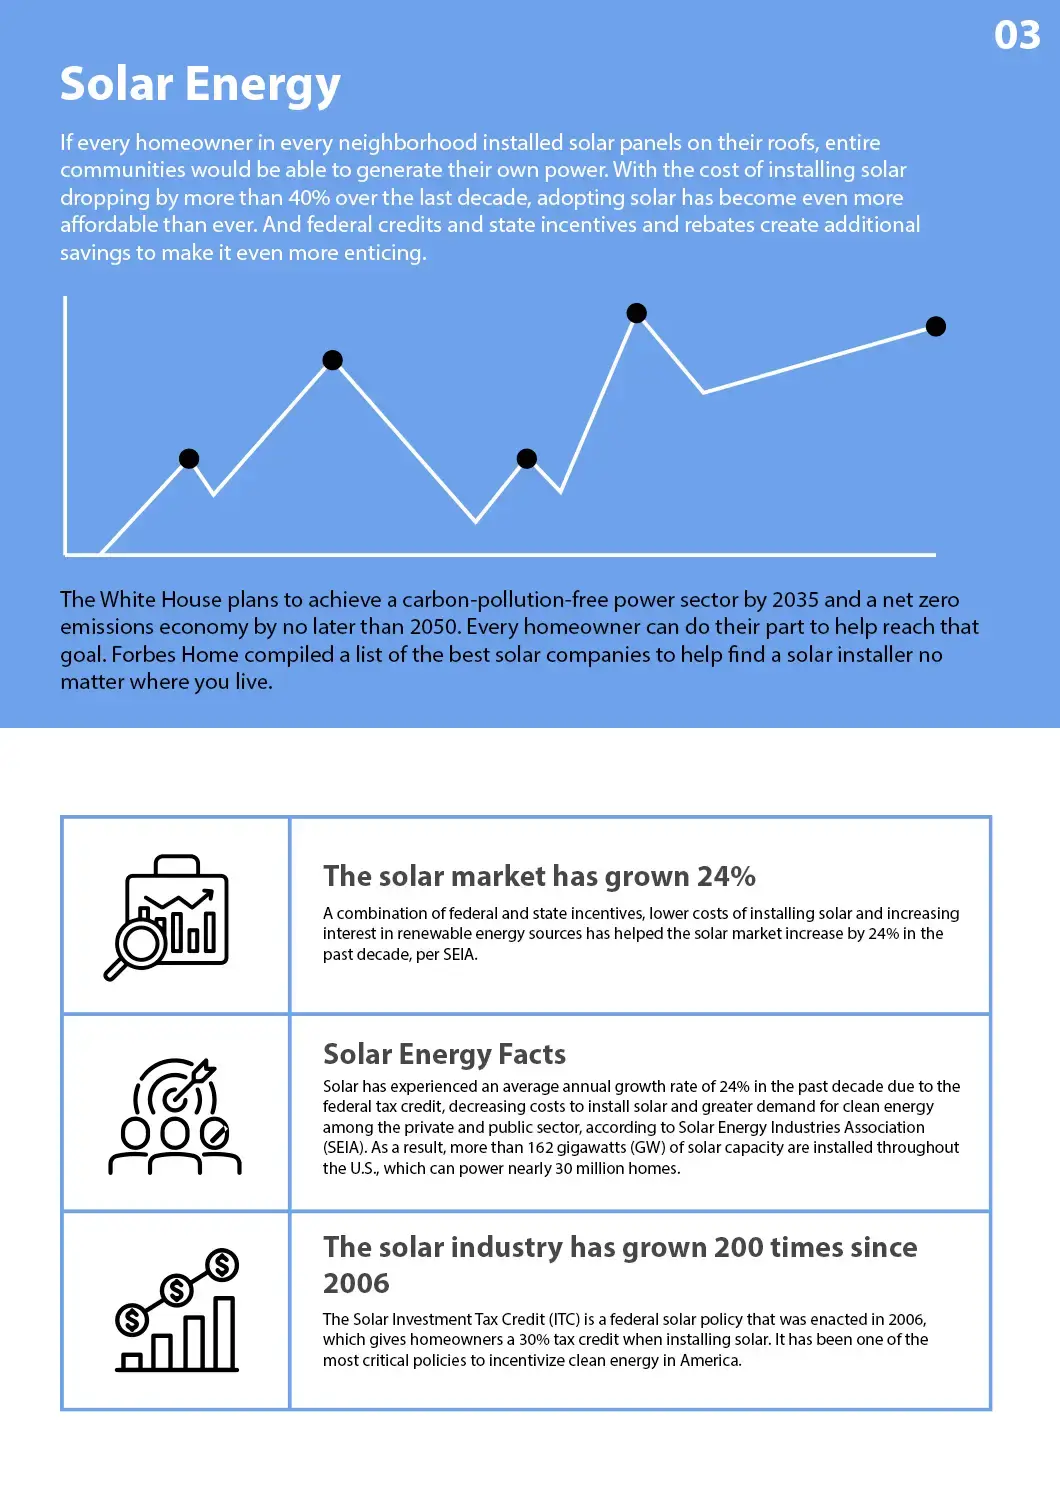
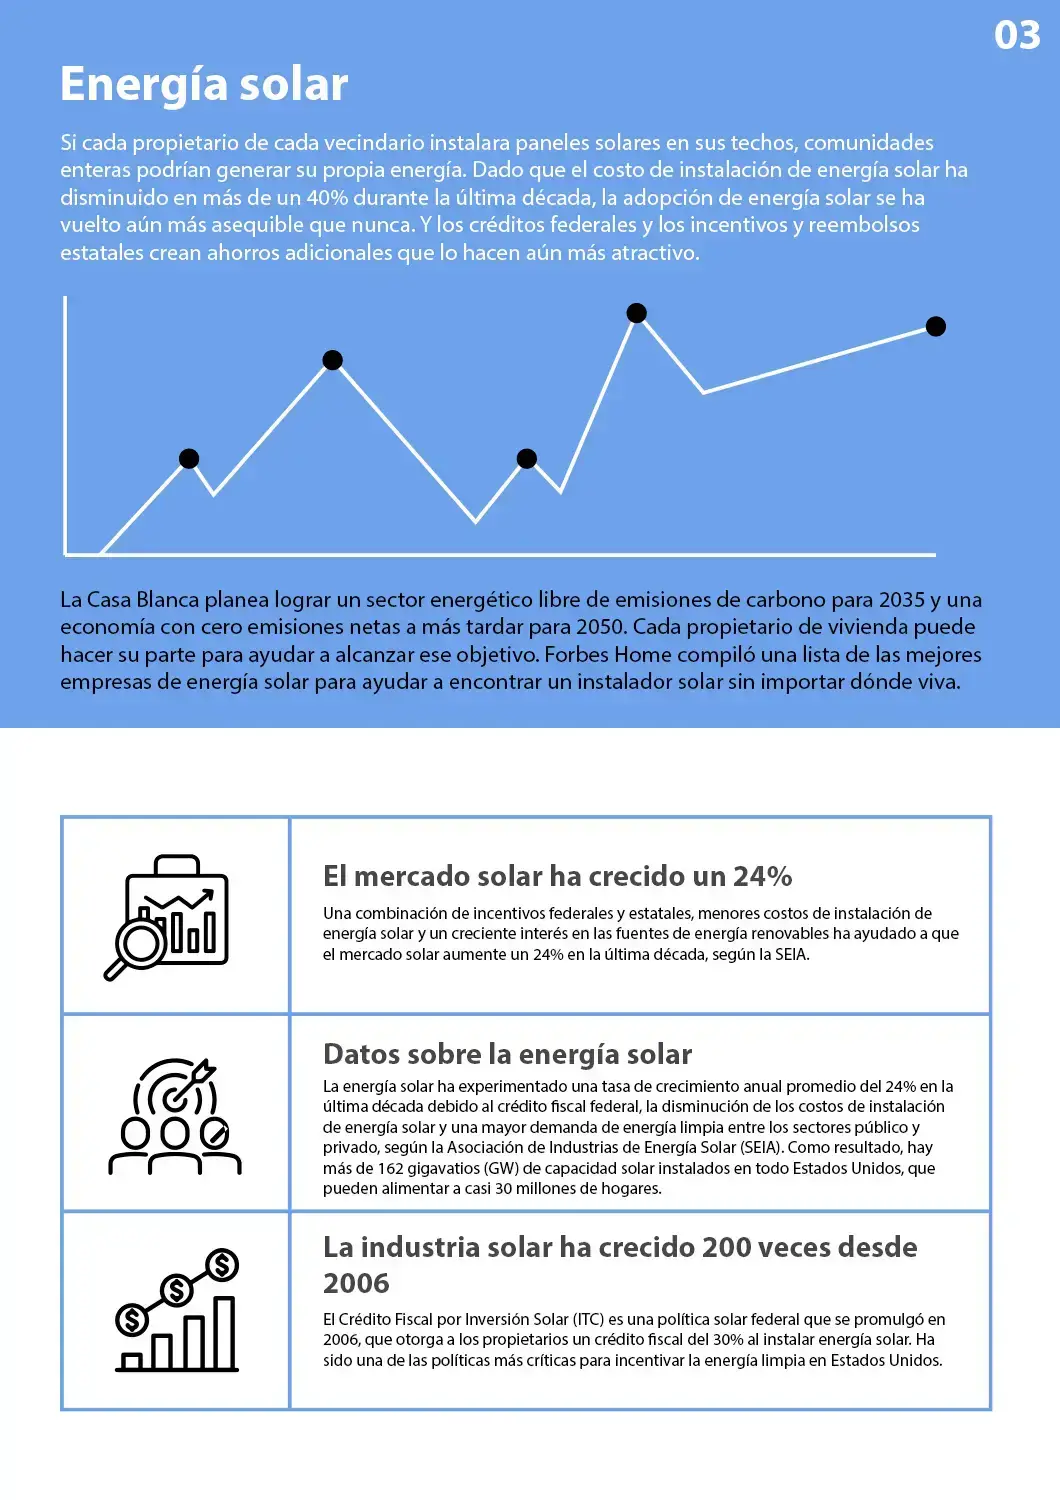
यहां कुछ भी दो राज्यों के बीच स्प्रेडशीट में नहीं खोला गया था।
सभी अनुवाद उदाहरण देखें →एक कार्यशील आदेश जो पुन: कार्य से बचता है
कैटलॉग का स्थानीयकरण एक पाइपलाइन है, और महंगी गलतियाँ बीच में होने के बजाय इसके सिरों पर होती हैं।
- 1
साफ-सुथरा निर्यात करें और बोली को नोट करें
डेटा के मालिक सिस्टम से सीधे निर्यात लें। इसे एक बार सादे टेक्स्ट एडिटर में खोलें, स्प्रेडशीट में नहीं, और नोट करें कि कौन सा वर्ण फ़ील्ड को अलग करता है और क्या मान उद्धरण चिह्नों में संलग्न हैं।
- 2
उन कॉलम को चिह्नित करें जिन्हें आप नहीं छूना चाहते
पहचानकर्ता, कुंजियाँ, लिंक, स्थिति मान और कोड। यदि निर्यात बहुत चौड़ा है, तो इसे उन कॉलमों तक काटना अक्सर तेज़ होता है जिनमें गद्य होता है और बाद में कुंजी पर फिर से जुड़ना होता है।
- 3
अपनी भाषाएँ अपलोड करें और चुनें
एक ईमेल पते के साथ एक खाता बनाएँ, डेटा डालें, और स्रोत और लक्ष्य सेट करें। अपलोड 1 GB तक चलते हैं, इसलिए एक पूरी कैटलॉग को बैचों में विभाजित करने के बजाय एक ही जॉब के रूप में पूरा किया जाता है।
- 4
पहले स्टेजिंग कॉपी में फिर से आयात करें
उत्पादन से पहले परिणाम को परीक्षण वातावरण में लोड करें। मूल के विरुद्ध रिकॉर्ड गणना की जाँच करें, लेआउट समस्याओं के लिए सबसे लंबे अनुवादित मानों को देखें, और पुष्टि करें कि एक्सेंटेड वर्ण यात्रा से बच गए।
डेटासेट वाले लोगों के प्रश्न
क्या सीमांकक बदल जाता है यदि मैं किसी ऐसी भाषा में अनुवाद करता हूँ जो दशमलव अल्पविराम का उपयोग करती है?
जिस सेपरेटर से आपने अपलोड किया है, वही सेपरेटर आपको वापस मिलता है। इसे बदलने का मतलब सामग्री के बजाय संरचना को फिर से लिखना होगा, और यह जो कुछ भी दूसरे छोर पर डेटा का उपभोग करता है उसे तोड़ देगा। यदि आपको विशेष रूप से एक अर्धविराम-पृथक संस्करण की आवश्यकता है क्योंकि परिणाम उस तरह से कॉन्फ़िगर की गई मशीन पर स्प्रेडशीट में खोला जाएगा, तो अनुवाद के बाद इसे ऐसे टूल से परिवर्तित करें जो दोनों बोलियों को समझता हो।
मैं उत्पाद कोड और पहचानकर्ताओं का अनुवाद होने से कैसे रोकूं?
उन्हें स्पष्ट रूप से पहचाने गए कॉलम में रखें और, जहां संभव हो, केवल गद्य कॉलम को प्रोसेसिंग के लिए भेजें और बाद में कुंजी पर फिर से जोड़ें। स्पष्ट रूप से कोड के बजाय शब्द वाले मान वैसे ही छोड़ दिए जाते हैं, लेकिन सबसे सुरक्षित व्यवस्था वह है जहां अस्पष्टता कभी उत्पन्न नहीं होती है। इस बीच किसी स्प्रेडशीट को उन कॉलम को छूने न दें, क्योंकि यह किसी भी अनुवाद के बावजूद उन्हें फिर से प्रारूपित कर देगा।
मेरे एक्सेंट वाले अक्षर प्रतीकों की स्ट्रिंग के रूप में वापस आ गए। क्या हुआ?
यह एक एन्कोडिंग बेमेल है, अनुवाद समस्या नहीं। परिणाम लगभग निश्चित रूप से सही यूनिकोड है जिसे कुछ लेगेसी सिंगल-बाइट एन्कोडिंग की अपेक्षा कर रहा है, या इसका विपरीत। इसे एक टेक्स्ट एडिटर में खोलें जो आपको एन्कोडिंग को स्पष्ट रूप से चुनने देता है और पुष्टि करें कि कुछ भी खो गया है यह मानने से पहले आपके पास वास्तव में क्या है। यदि गंतव्य एक स्प्रेडशीट है, तो शुरुआत में बाइट ऑर्डर मार्कर आमतौर पर इसे तय करता है।
अल्पविराम या लाइन ब्रेक वाले मानों का क्या होता है?
वे संलग्न रहते हैं। किसी भी मान में सेपरेटर, एक उद्धरण चिह्न या एक नई लाइन होने पर उसे उद्धरण चिह्नों में लपेटा जाना चाहिए, और ऐसे मान के अंदर एक शाब्दिक उद्धरण चिह्न को दोगुना किया जाना चाहिए। क्योंकि अनुवादित पाठ में ऐसा विराम चिह्न हो सकता है जो मूल में नहीं था, उस संलग्नक को स्रोत से कॉपी करने के बजाय परिणाम पर लागू किया जाना चाहिए।
क्या प्लेसहोल्डर और चर टोकन बने रहेंगे?
उन्हें होना चाहिए, और एक नमूना जांचना सार्थक है। टोकन जैसे कि एक अक्षर के बाद प्रतिशत चिह्न, कोष्ठक में एक क्रमांकित स्लॉट या एक नामित चर रनटाइम पर डाले गए मानों के लिए पते हैं। उनमें से एक का अनुवाद करने का मतलब है कि मान कभी स्क्रीन पर नहीं पहुंचता है, इसलिए शिपिंग से पहले आउटपुट में सबसे लंबे इंटरफ़ेस स्ट्रिंग्स में से कुछ को स्कैन करें।
मेरी स्ट्रिंग्स जर्मन में बहुत लंबी हो जाती हैं। क्या इससे यहाँ कोई फर्क पड़ता है?
डेटा स्वयं के लिए नहीं, जिसकी कोई चौड़ाई नहीं है। यह उस चीज़ के लिए मायने रखता है जो इसे प्रदर्शित करती है। जर्मन और रूसी के लिए अंग्रेजी पर एक-तिहाई से एक-पांचवें तक का विस्तार सामान्य है, जबकि चीनी और जापानी आमतौर पर सिकुड़ते हैं। अनुवादित कॉलम को लंबाई के अनुसार छाँटें और अपने लेआउट के मुकाबले चरम सीमाओं को देखें, और किसी भी डेटाबेस कॉलम को निश्चित वर्ण सीमा के साथ जांचें।
मैं एक बार में कितना बड़ा डेटासेट भेज सकता हूँ?
Pro और Business प्लान पर 1 GB तक, या पांच हजार पृष्ठों की समतुल्य सामग्री। यह लाखों पंक्तियों वाले कैटलॉग को कवर करता है। पूरे को एक साथ भेजना भी स्थिरता के लिए बेहतर है, क्योंकि पंक्ति 12 और पंक्ति 90,000 में दिखाई देने वाले शब्द को समान रूप से संभाला जाता है।
एक विस्तृत निर्यात पर मुझसे क्या शुल्क लिया जाता है?
टेक्स्ट, ग्रिड नहीं। खाली सेल, संख्यात्मक कॉलम और पहचानकर्ता कॉलम गद्य नहीं हैं। Free पर प्रत्येक फ़ाइल का भुगतान अलग से आधा सेंट प्रति शब्द की दर से किया जाता है, जिसमें $0.99 न्यूनतम होता है, जबकि सदस्यता हर 30 दिनों में शामिल पृष्ठों का उपयोग करती है और उस बिंदु के बाद केवल प्रति शब्द बिल करती है। यह एक बड़े कैटलॉग का अनुमान लगाना आसान बनाता है।
निर्यात भेजें, संरचना बनाए रखें
डेटा को ठीक उसी तरह अपलोड करें जैसे आपके सिस्टम ने इसे उत्पन्न किया था, लक्ष्य भाषा चुनें, और हर रिकॉर्ड में समान संख्या में कॉलम वाली ग्रिड वापस प्राप्त करें और कुंजियाँ अभी भी जुड़ने योग्य हों।
हमारे भागीदार


संबंधित अनुवाद सेवाएँ
फ़ाइल प्रारूप
PDF उपकरण