
CSV-översättare
Produktkataloger, export och datamängder översatta kolumn för kolumn, med avgränsare, citattecken och identifieringskolumner lämnade exakt som din parser förväntar sig att hitta dem.
Ladda upp eller släpp dokument för översättning
Max filstorlek 1 GB
Strukturen stöds av två tecken
Komma-separerade värden är knappt ett format. Det finns en allmänt följd beskrivning av den vanliga dialekten, men ingen auktoritet upprätthåller den, så vad du faktiskt får är en av flera konventioner. Hela rutnätet vilar på två beslut: vilket tecken som separerar fälten i en post, och vilken sekvens som avslutar en post. Gör antingen fel och en prydlig tabell blir en enda ojämn kolumn.
Avgränsaren är inte alltid ett kommatecken. Kalkylprogram i länder som skriver decimaler med kommatecken använder som standard semikolon istället, vilket är anledningen till att en export från en tysk eller fransk maskin ofta vägrar att öppnas rent någon annanstans. Tabbar och vertikalstreck används båda i stor utsträckning, vanligtvis valda just för att innehållet är fullt av kommatecken.
Varje post måste ha samma antal fält som rubriken, eftersom det antalet är hur en parser vet vilket värde som tillhör vilken kolumn. Inget i datan meddelar detta. Det är en invariant som antingen håller eller tyst slutar hålla halvvägs ner i en stor export, vid vilken punkt allt nedan skiftar en kolumn åt vänster och ser trovärdigt ut.
Fyra sätt som översatt text bryter en post
Detta är de fel som inte meddelar sig själva. Exporten öppnas fortfarande, radantalet ser fortfarande ungefär rätt ut, och skadan visar sig senare i vad som än konsumerar datan.
- En ny avgränsare dyker upp inuti ett värde. En engelsk produktbeskrivning utan kommatecken blir en fransk med två. Om fältet inte var citerat tidigare, måste det nu vara det, annars läser parsern ett värde som tre och skiftar varje kolumn efter det.
- Ett citattecken hamnar inuti ett citerat värde. Inuti ett inneslutet fält måste ett bokstavligt dubbelt citattecken skrivas två gånger för att undvika sig själv. Språk som citerar med olika märken, och alla processer som konverterar raka märken till typografiska, kan lämna ett oskyddat tecken mitt i ett värde där det avslutar fältet tidigt.
- En radbrytning smyger sig in i en cell. En post slutar vid en ny rad om inte den nya raden sitter inom citattecken. Översatt marknadsföringstext som får en styckesbrytning kommer att dela en post i två, och den andra halvan kommer att ha fel antal fält.
- En platshållare översätts. Strängar avsedda för programvara innehåller ofta substitutions-tokens, ett procenttecken följt av en bokstav, en numrerad plats i klamrar, en namngiven variabel. De är adresser för värden som infogas vid körning, inte ord, och att översätta en betyder att värdet aldrig visas.
Hälften av dina kolumner är inte språk
En datamängd blandar prosa avsedd för människor med nycklar avsedda för maskiner, och de sitter sida vid sida utan något som skiljer dem åt förutom kolumnrubriken. Ta reda på vilken som är vilken innan du börjar, eftersom en översatt identifierare är värre än en oöversatt beskrivning.
Lämna dessa ifred
- Själva rubrikraden där rubrikerna är fältnamn som används av kod snarare än etiketter som visas för en person
- Lagerkoder, katalognummer, unika identifierare och allt som används som nyckel för att koppla samman två datamängder
- Webbadresser och slug-delen av en, eftersom att ändra den bryter länken och dess ranking
- Statusvärden som programvara jämför mot en fast lista, såsom en orderstatus eller en ja-och-nej-flagga
- Länder, språk och valutakoder, som redan är standardiserade förkortningar
- Datum skrivna i ordningen år-månad-dag, siffror och allt som kommer att tolkas snarare än läsas
Det här är de du kom för
- Produkttitlar och långa beskrivningar, vilket vanligtvis utgör den största delen av ordantalet
- Kategori- och samlingsnamn som kunderna ser dem
- Attributvärden med betydelse, som en färg, ett material eller ett storleksord
- Gränssnittssträngar utdragna för lokalisering, minus deras platshållare
- Supportartikelkroppar, färdiga svar och e-postmallar som rader
- Kolumnrubriker där exporten är avsedd att öppnas av en person snarare än ett program
Två saker som skadar data innan översättning ens börjar
Öppna den i ett kalkylprogram
Att dubbelklicka på en export och spara den igen är det mest pålitliga sättet att förstöra en katalog. Kalkylprogram gissar typen av varje värde de ser, och deras gissningar är självsäkra och felaktiga:
- Ett trettonsiffrigt artikelnummer blir till vetenskaplig notation och förlorar sina sista siffror för alltid
- Ett postnummer som börjar med en nolla förlorar nollan
- Allt som liknar en dag och en månad skrivs om till ett datum i det lokala formatet
- Långa identifierare över femton siffror rundas av, tyst
Om du måste inspektera data först, använd importdialogen och ställ in identifieringskolumnerna på text snarare än att låta programmet bestämma. Ännu bättre, ladda upp exporten exakt som ditt system producerade den.
Frågan om byteordningsmarkör
Inget inuti data säger vilken teckenkodning den använder, så en markör på tre byte placeras ibland allra först för att signalera en. Den markören hjälper och stjälper beroende på vad som öppnar data nästa gång.
Kalkylprogram på Windows använder den för att känna igen Unicode-innehåll, och utan den kommer accenterade och icke-latinska tecken ut som symbolsträngar. Många programmeringsbibliotek, däremot, tar inte bort den, så den första kolumnrubriken kommer in med tre osynliga tecken klistrade på framsidan och varje uppslag mot den rubriken misslyckas.
Bestäm efter destination: behåll markören om en person kommer att öppna resultatet i ett kalkylprogram, släpp den om ett program kommer att läsa den. Svaret på nästan varje fråga om korrupta accenterade tecken finns någonstans i detta stycke.
Vad ett dataset kostar att bearbeta
Prissatt per textvolym, så en bred katalog med korta värden är billigare än en smal med långa beskrivningar.
Free
Inget kort behövs för att registrera dig
- 0,005 $/ord AI-översättning
- 1 USD per sida för skanningar och bild-PDF:er
- 120+ språk
- Filer upp till 20 MB och 20 sidor
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG och CSV
- Endast 24-timmars fillagring
- PDF-redigerare och PDF till DOCX-konverterare
- Avbryt när som helst
- Ej inkluderat: E-postsupport
- Ej inkluderat: Teamåtkomst
- Ej inkluderat: Obegränsade gratis PDF-förhandsgranskningar
- Ej inkluderat: Ordlista
Storage
eller 149 USD/år
- 0,005 $/ord AI-översättning
- 1 USD per sida för skanningar och bild-PDF:er
- 120+ språk
- Filer upp till 100 MB och 100 sidor
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG och CSV
- Obegränsad fillagring
- PDF-redigerare och PDF till DOCX-konverterare
- E-postsupport
- Avbryt när som helst
- Ej inkluderat: Teamåtkomst
- Ej inkluderat: Obegränsade gratis PDF-förhandsgranskningar
- Ej inkluderat: Ordlista
Pro
eller 499 USD/år
- 0,004 USD per ord för AI-översättning
- 0,80 USD per sida för skanningar och bild-PDF:er
- 120+ språk
- Filer upp till 1 000 MB och 5 000 sidor
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG och CSV
- Obegränsad fillagring
- PDF-redigerare och PDF till DOCX-konverterare
- E-postsupport
- Teamåtkomst för upp till 5 medlemmar
- Obegränsade gratis PDF-förhandsgranskningar
- Ordlista
- Avbryt när som helst
Företag
149,99 USD/månad, på begäran. AI-översättning för 0,003 USD/ord (0,60 USD per sida), filer upp till 1 000 MB och 5 000 sidor, obegränsad fillagring och teamåtkomst för upp till 15 medlemmar.
Rader in, rader ut
Förstora en miniatyrbild för att jämföra en källsida med dess resultat. Vad paren demonstrerar:
- Antal kolumner per post är oförändrat från topp till botten.
- Värden som var omgivna av citattecken är fortfarande omgivna.
- Koder, nycklar och numeriska värden passerar igenom orörda.
- Endast de mänskligt läsbara kolumnerna kommer tillbaka på ett nytt språk.
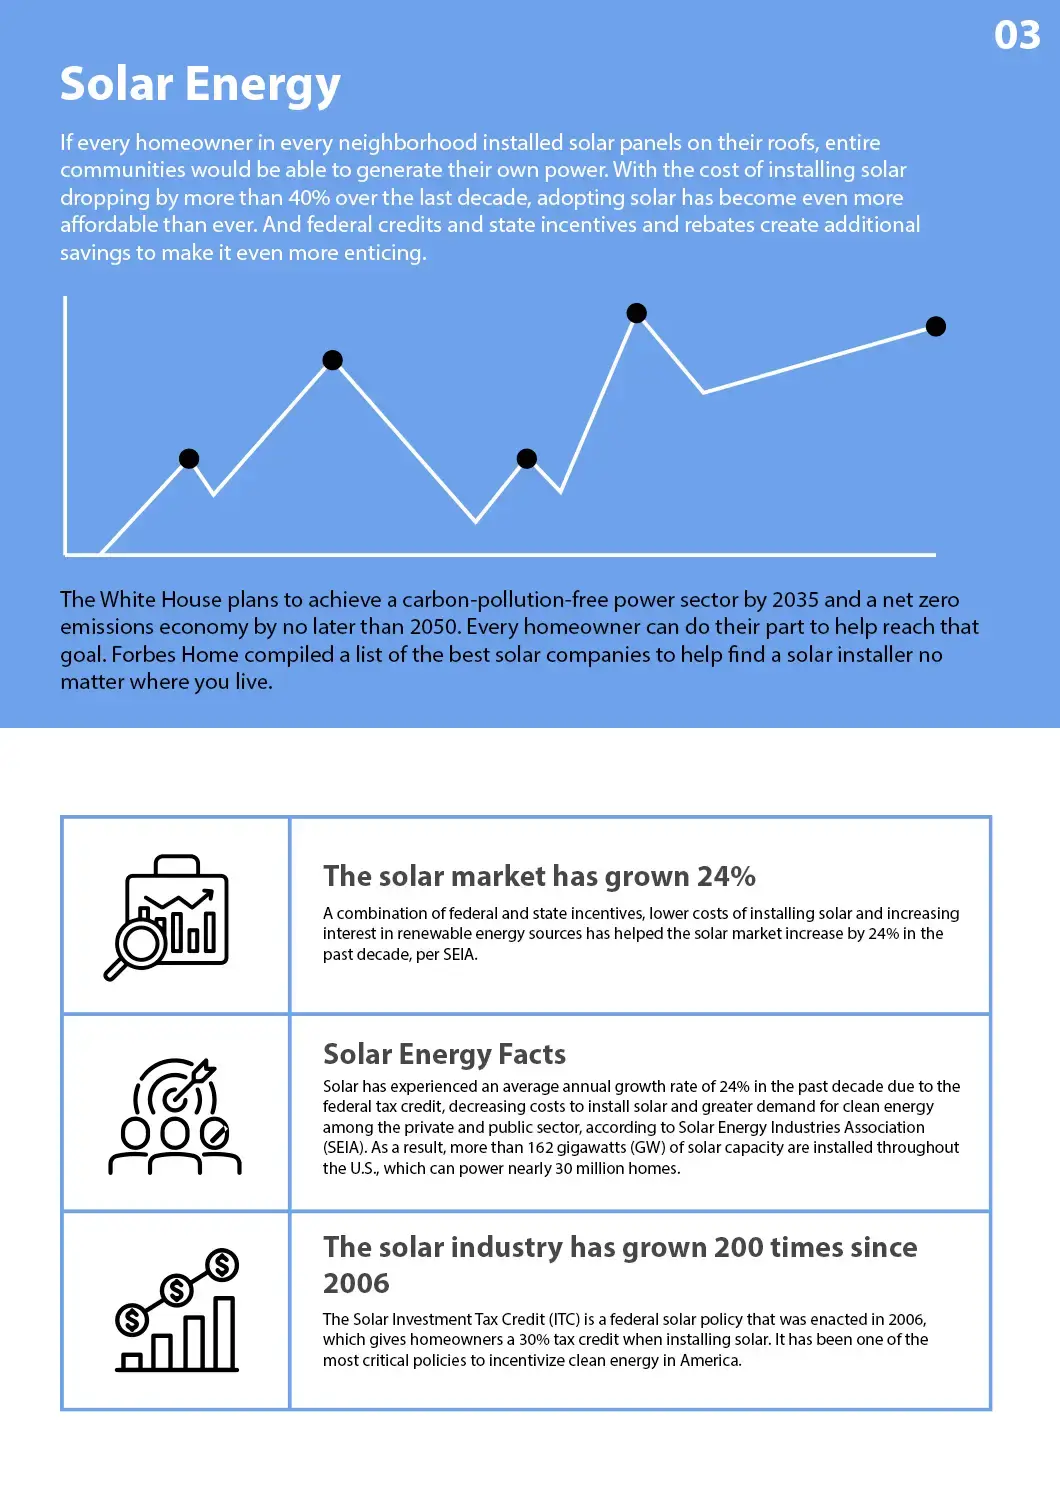
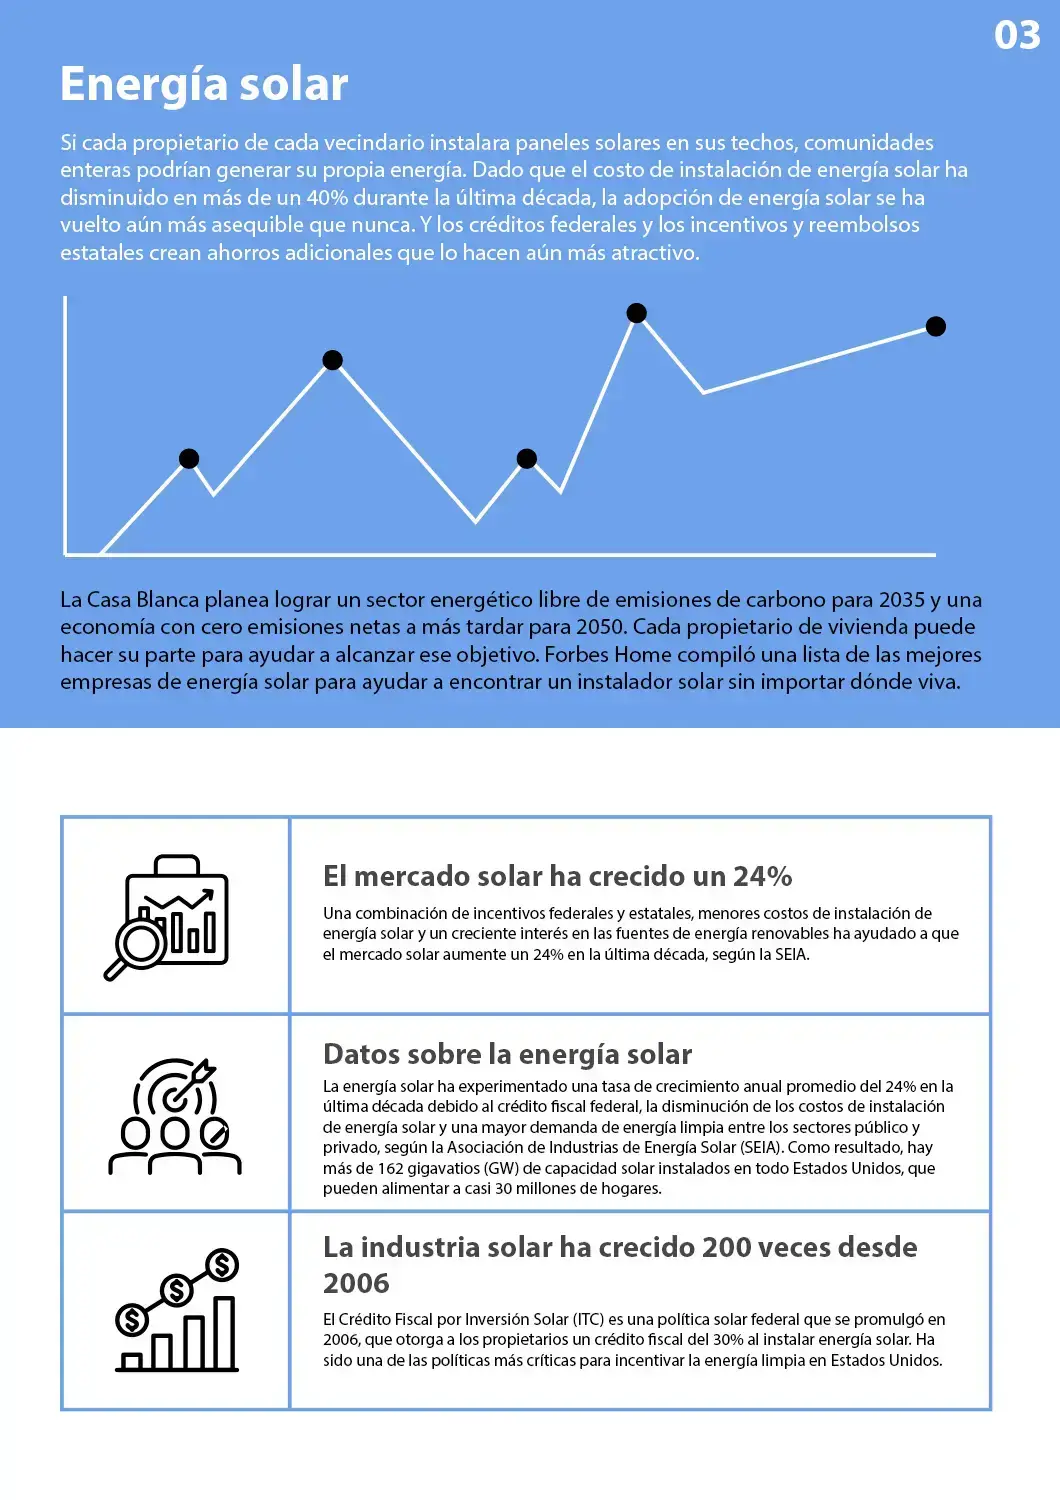
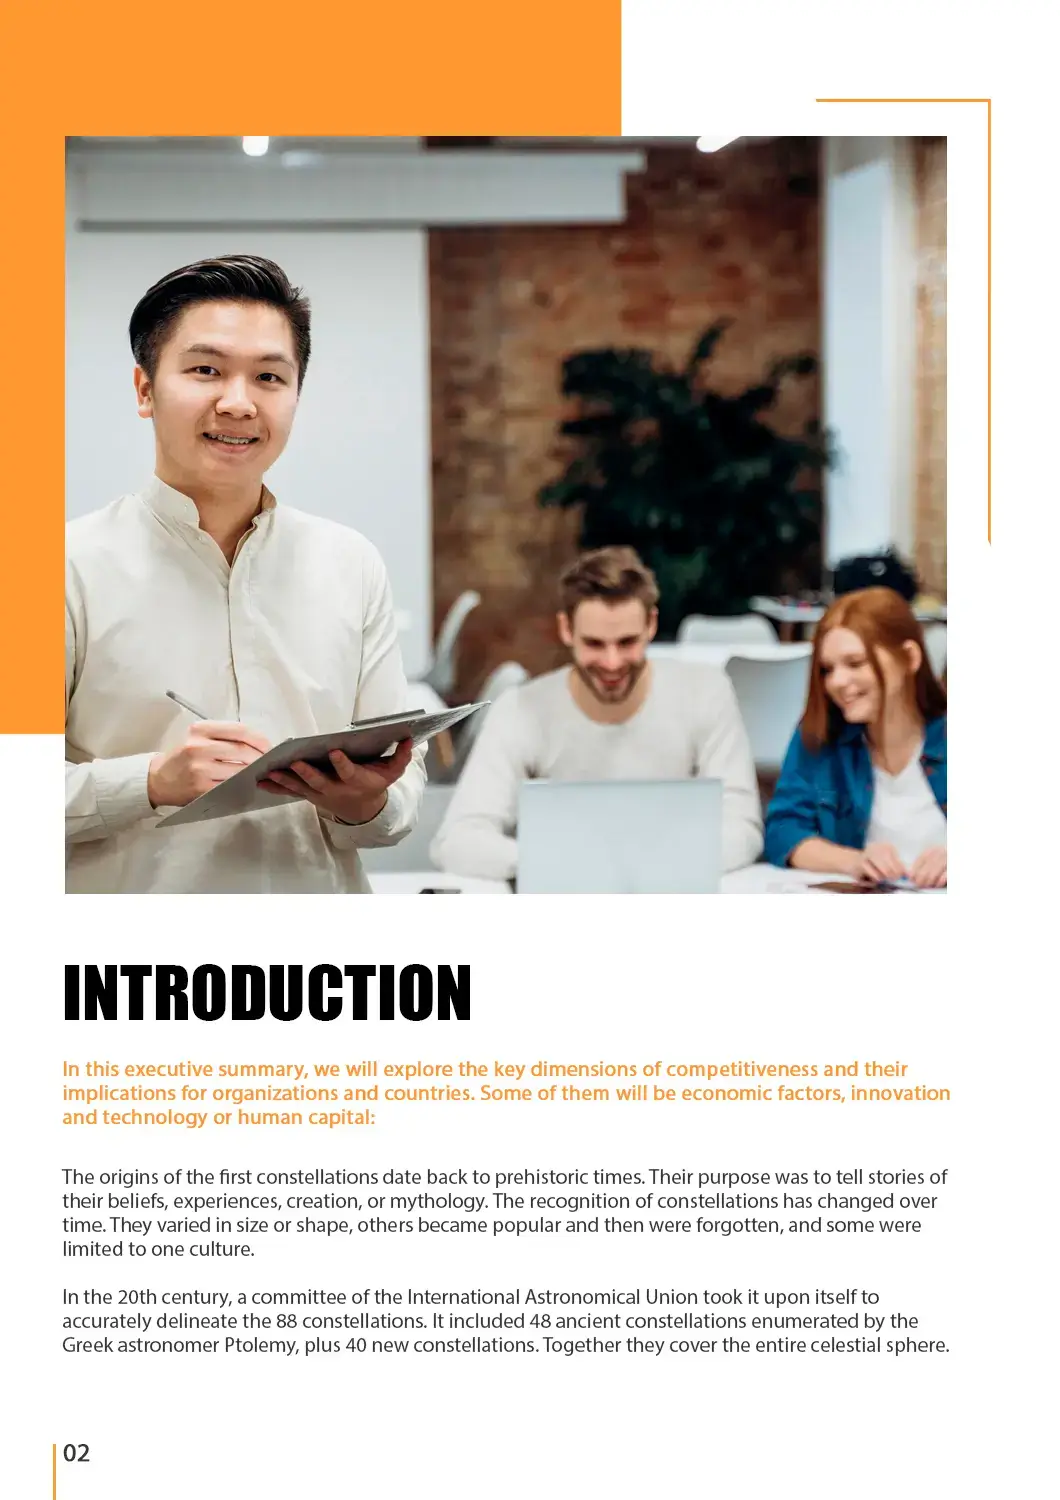
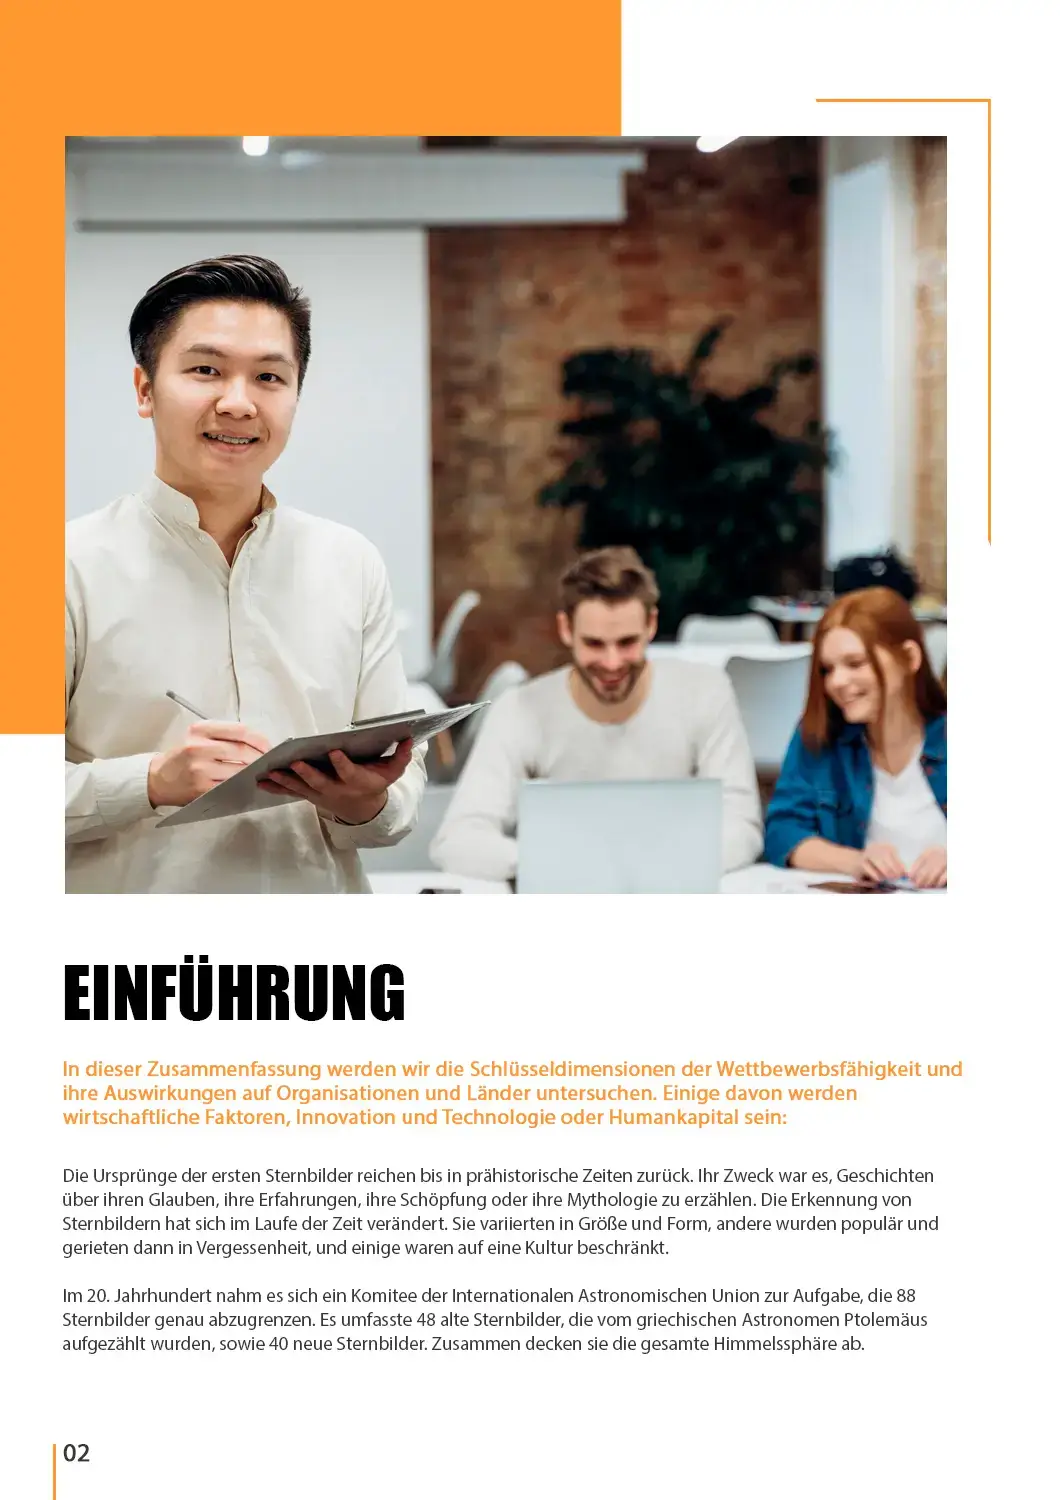
Inget här öppnades i ett kalkylprogram mellan de två tillstånden.
Se alla översättningsexempel →Ett fungerande arbetsflöde som undviker omarbete
Lokalisering av en katalog är en pipeline, och de kostsamma misstagen sker alla i dess ändar snarare än i mitten.
- 1
Exportera rent och notera dialekten
Ta exporten direkt från systemet som äger data. Öppna den en gång i en enkel textredigerare, inte ett kalkylprogram, och notera vilken tecken som separerar fälten och om värden är omgivna av citattecken.
- 2
Markera kolumnerna du inte vill ska röras
Identifierare, nycklar, länkar, statusvärden och koder. Om exporten är mycket bred är det ofta snabbare att skära ner den till de kolumner som innehåller prosa och sedan återansluta på nyckeln.
- 3
Ladda upp och välj dina språk
Skapa ett konto med en e-postadress, släpp in datan och ställ in käll- och målspråk. Uppladdningar går upp till 1 GB, så en hel katalog hanteras som ett jobb snarare än att delas upp i omgångar.
- 4
Importera först till en staging-kopia
Ladda in resultatet i en testmiljö före produktion. Kontrollera antalet poster mot originalet, titta på de längsta översatta värdena för layoutproblem och bekräfta att accenterade tecken överlevde resan.
Frågor från personer med datamängder
Ändras avgränsaren om jag översätter till ett språk som använder decimaltecken?
Avgränsaren du laddade upp med är avgränsaren du får tillbaka. Att ändra den skulle innebära att skriva om strukturen snarare än innehållet, och det skulle bryta vad som än tar emot data i andra änden. Om du specifikt behöver en semikolonseparerad version eftersom resultatet kommer att öppnas i ett kalkylblad på en maskin som är konfigurerad på det sättet, konvertera det efter översättningen med ett verktyg som förstår båda dialekterna.
Hur förhindrar jag att produktkoder och identifierare översätts?
Behåll dem i tydligt identifierade kolumner och, där det är möjligt, skicka endast textkolumnerna för bearbetning och återanslut dem i nyckeln efteråt. Värden som uppenbart är koder snarare än ord lämnas som de är, men det säkraste arrangemanget är det där tvetydigheten aldrig uppstår. Låt aldrig ett kalkylblad röra vid dessa kolumner under tiden, eftersom det kommer att formatera om dem oavsett översättning.
Mina accenttecken kom tillbaka som symbolsträngar. Vad hände?
Det är en felaktig teckenkodning, inte ett översättningsproblem. Resultatet är nästan säkert korrekt Unicode som läses av något som förväntar sig en äldre teckenkodning med en byte, eller tvärtom. Öppna det i en textredigerare som låter dig välja teckenkodning explicit och bekräfta vad du faktiskt har innan du antar att något har gått förlorat. Om ett kalkylblad är destinationen är byteordningsmarkören i början vanligtvis det som avgör det.
Vad händer med värden som innehåller kommatecken eller radbrytningar?
De förblir inneslutna. Alla värden som innehåller avgränsaren, ett citattecken eller en ny rad måste omges av citattecken, och ett bokstavligt citattecken inuti ett sådant värde måste dubbleras. Eftersom översatt text kan få skiljetecken som originalet inte hade, måste den inneslutningen tillämpas på resultatet snarare än kopieras från källan.
Kommer platshållare och variabla token att överleva?
Det borde de, och det är värt att kontrollera ett urval. Token som ett procenttecken följt av en bokstav, en numrerad plats i klamrar eller en namngiven variabel är adresser för värden som infogas vid körning. Att översätta en sådan innebär att värdet aldrig når skärmen, så skanna en handfull av de längsta gränssnittssträngarna i utdata innan leverans.
Mina strängar blir mycket längre på tyska. Spelar det någon roll här?
Inte för själva datan, som inte har någon bredd. Det spelar roll för det som visar den. Expansion på en femtedel till en tredjedel jämfört med engelska är normalt för tyska och ryska, medan kinesiska och japanska vanligtvis krymper. Sortera den översatta kolumnen efter längd och titta på extremvärdena mot din egen layout, och kontrollera eventuella databaskolumner med en fast teckengräns.
Hur stor datamängd kan jag skicka på en gång?
Upp till 1 GB, eller fem tusen sidor motsvarande innehåll, på Pro- och Enterprise-planerna. Det täcker kataloger med hundratusentals rader. Att skicka hela saken som ett jobb är också bättre för konsekvens, eftersom en term som förekommer i rad 12 och rad 90 000 hanteras på samma sätt.
Vad debiteras jag för vid en bred export?
Texten, inte rutnätet. Tomma celler, numeriska kolumner och identifieringskolumner är inte prosa. Varje fil faktureras separat, eftersom ingen plan kommer med ord inkluderade: en halv cent per ord på Free och Storage, 0,004 $ på Pro och 0,003 $ på Enterprise, med 0,99 $ som golv. Det gör en stor katalog lätt att uppskatta från ett ordantal.
Skicka exporten, behåll strukturen
Ladda upp datan exakt som ditt system producerade den, välj målspråk och få tillbaka ett rutnät med samma antal kolumner i varje post och nycklar som fortfarande kan kopplas ihop.
Våra partners




Relaterade översättningstjänster
Filformat
PDF-verktyg