
CSV Vertaler
Productcatalogi, exports en datasets kolom voor kolom vertaald, met de scheidingstekens, de aanhalingstekens en de identificatiekolommen precies zoals uw parser verwacht ze te vinden.
Upload of laat document vallen om te vertalen
Max. bestandsgrootte 1 GB
- OCR voor scans en foto's
- 108 talen
- Originele lay-out behouden
De structuur wordt ondersteund door twee tekens
Door komma's gescheiden waarden is nauwelijks een formaat. Er is een breed gevolgde beschrijving van het gemeenschappelijke dialect, maar geen autoriteit handhaaft het, dus wat u daadwerkelijk ontvangt is een van de verschillende conventies. Het hele raster rust op twee beslissingen: welk teken scheidt de velden in een record, en welke reeks beëindigt een record. Als u een van beide verkeerd krijgt, wordt een nette tabel één rafelige kolom.
Het scheidingsteken is niet altijd een komma. Spreadsheetsoftware in landen die decimalen met een komma schrijven, standaardiseert in plaats daarvan naar een puntkomma, daarom weigert een export van een Duitse of Franse machine elders schoon te openen. Tabs en verticale strepen worden beide veel gebruikt, meestal juist gekozen omdat de inhoud vol komma's zit.
Elk record moet hetzelfde aantal velden bevatten als de header, omdat die telling is hoe een parser weet welke waarde bij welke kolom hoort. Niets in de gegevens kondigt dit aan. Het is een invariant die ofwel geldt ofwel halverwege een grote export stilzwijgend ophoudt te gelden, waarna alles eronder één kolom naar links verschuift en plausibel lijkt.
Vier manieren waarop vertaalde tekst een record breekt
Dit zijn de storingen die zichzelf niet aankondigen. De export opent nog steeds, het aantal rijen ziet er nog steeds ongeveer goed uit, en de schade verschijnt later in wat de gegevens verbruikt.
- Een nieuw scheidingsteken verschijnt binnen een waarde. Een Engelse productbeschrijving zonder komma's wordt een Franse met twee. Als het veld voorheen niet werd aangehaald, moet het nu wel, anders leest de parser één waarde als drie en verschuift alle kolommen ernaar.
- Een aanhalingsteken komt terecht in een aangehaalde waarde. Binnen een omsloten veld moet een letterlijk dubbel aanhalingsteken twee keer worden geschreven om zichzelf te ontsnappen. Talen die met verschillende tekens citeren, en elk proces dat rechte tekens omzet in typografische tekens, kunnen een niet-ontsnapte teken midden in een waarde achterlaten waar het het veld vroegtijdig beëindigt.
- Een regeleinde sluipt in een cel. Een record eindigt bij een nieuwe regel, tenzij die nieuwe regel binnen aanhalingstekens staat. Vertaalde marketingteksten die een paragraafonderbreking krijgen, splitsen één record in tweeën, en de tweede helft heeft het verkeerde aantal velden.
- Een placeholder wordt vertaald. Tekstreeksen bestemd voor software bevatten vaak substitutietokens, een procentteken gevolgd door een letter, een genummerde sleuf in accolades, een benoemde variabele. Het zijn adressen voor waarden die tijdens runtime worden ingevoegd, geen woorden, en het vertalen ervan betekent dat de waarde nooit verschijnt.
De helft van uw kolommen is geen taal
Een dataset mixt proza bedoeld voor mensen met sleutels bedoeld voor machines, en ze staan naast elkaar zonder iets om ze te onderscheiden behalve de kolomkop. Bepaal welke wat is voordat u begint, want een vertaalde identifier is erger dan een onvertaalde beschrijving.
Laat deze met rust
- De headerrij zelf waar de koppen veldnamen zijn die door code worden gebruikt in plaats van labels die aan een persoon worden getoond
- Voorraadcodes, catalogusnummers, unieke identificaties en alles wat als sleutel wordt gebruikt om twee datasets te koppelen
- Webadressen en het slug-gedeelte ervan, aangezien het wijzigen ervan de link en de ranking ervan verbreekt
- Statuswaarden die software vergelijkt met een vaste lijst, zoals een bestelstatus of een ja/nee-vlag
- Land-, taal- en valutacodes, die al gestandaardiseerde afkortingen zijn
- Datums in de volgorde jaar-maand-dag, getallen en alles wat geparsed wordt in plaats van gelezen
Dit zijn degene waar je naar op zoek bent
- Producttitels en lange beschrijvingen, wat meestal het grootste deel van de woordtelling is
- Categorie- en collectienamen zoals klanten ze zien
- Attribuutwaarden met betekenis, zoals een kleur, een materiaal of een maatwoord
- Interface-teksten die eruit zijn gehaald voor lokalisatie, minus hun placeholders
- Ondersteuningsartikelteksten, standaardantwoorden en e-mailsjablonen die als rijen worden bewaard
- Kolomkoppen waarbij de export bedoeld is om door een persoon te worden geopend en niet door een programma
Twee dingen die gegevens beschadigen voordat de vertaling zelfs maar begint
Openen in een spreadsheet
Dubbelklikken op een export en deze opnieuw opslaan is de meest betrouwbare manier om een catalogus te beschadigen. Spreadsheetsoftware raadt het type van elke waarde die het ziet, en de gissingen zijn zelfverzekerd en foutief:
- Een dertiencijferig artikelnummer wordt omgezet in wetenschappelijke notatie en verliest permanent zijn laatste cijfers
- Een postcode die begint met een nul verliest de nul
- Alles wat lijkt op een dag en een maand wordt herschreven als een datum in het lokale formaat
- Lange identifiers van meer dan vijftien cijfers worden stilzwijgend afgerond
Als je de gegevens eerst moet inspecteren, gebruik dan de importdialoog en stel de identifierkolommen in op tekst in plaats van het programma te laten beslissen. Beter nog, upload de export precies zoals je systeem deze heeft geproduceerd.
De vraag over de byte order mark
Niets in de gegevens zegt welke tekencodering het gebruikt, dus een markering van drie bytes wordt soms helemaal aan het begin geplaatst om er een aan te geven. Die markering helpt en hindert, afhankelijk van wat de gegevens vervolgens opent.
Spreadsheetsoftware op Windows gebruikt het om Unicode-inhoud te herkennen, en zonder het komen geaccentueerde en niet-Latijnse tekens naar voren als reeksen symbolen. Veel programmeerbibliotheken strippen het daarentegen niet, dus de eerste kolomkop komt binnen met drie onzichtbare tekens aan de voorkant geplakt en elke zoekopdracht tegen die kop mislukt.
Beslis op basis van de bestemming: bewaar de markering als een persoon het resultaat in een spreadsheet zal openen, verwijder deze als een programma het zal lezen. Het antwoord op bijna elke vraag over beschadigde geaccentueerde tekens bevindt zich ergens in deze paragraaf.
Wat een dataset kost om te verwerken
Geprijsd per volume tekst, dus een brede catalogus met korte waarden is goedkoper dan een smalle vol met lange beschrijvingen.
Free
Geen kaart nodig om u aan te melden
- €0,005/woord AI-vertaling
- $1 per pagina voor scans en afbeeldings-PDF's
- 108 talen
- Bestanden tot 20 MB en 20 pagina's
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- Alleen 24-uurs bestandsopslag
- PDF-editor en PDF naar DOCX-converter
Basis
Meest populairWekelijks gefactureerd · annuleer op elk moment
Maandelijks gefactureerd
Eenmalige jaarlijkse facturering · bespaar 33%
- AI-vertalingen inbegrepen per maand
- Daarna €0,005/woord AI-vertaling
- Bestanden tot 100 MB en 300 pagina's
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- OCR voor gescande documenten
- Documentopslag
- Prioriteitsondersteuning
- 7 dagen gratis proefperiode op het maandelijkse abonnement
- Annuleer op elk moment
Pro
Maandelijks gefactureerd
Eenmalige jaarlijkse facturering · bespaar 34%
- AI-vertalingen inbegrepen per maand
- Daarna €0,004/woord AI-vertaling
- Bestanden tot 1 GB en 5.000 pagina's
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- Glosssarium
- Prioriteitswachtrij
- 5 teamleden
- API-verzoeken · 1.000 pagina's per maand
- MCP-toegang voor AI-assistenten
- Annuleer op elk moment
Zakelijk
Maandelijks gefactureerd
Eenmalige jaarlijkse facturering · bespaar 33%
- AI-vertalingen inbegrepen per maand
- Daarna €0,003/woord AI-vertaling
- Bestanden tot 1 GB en 5.000 pagina's
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- Glosssarium
- Prioriteitswachtrij
- 15 teamleden
- API-verzoeken · 5.000 pagina's per maand
- MCP-toegang voor AI-assistenten
- Annuleer op elk moment
Zakelijk
Meer volume, facturering of een aangepaste overeenkomst nodig? Neem contact met ons op voor een Enterprise-abonnement.
Rijen erin, rijen eruit
Vergroot een miniatuur om een bronpagina te vergelijken met het resultaat. Wat de paren aantonen:
- Kolomtelling per record blijft ongewijzigd van boven naar beneden.
- Waarden die tussen aanhalingstekens stonden, staan er nog steeds tussen.
- Codes, sleutels en numerieke waarden worden ongewijzigd doorgelaten.
- Alleen de leesbare kolommen komen terug in een nieuwe taal.
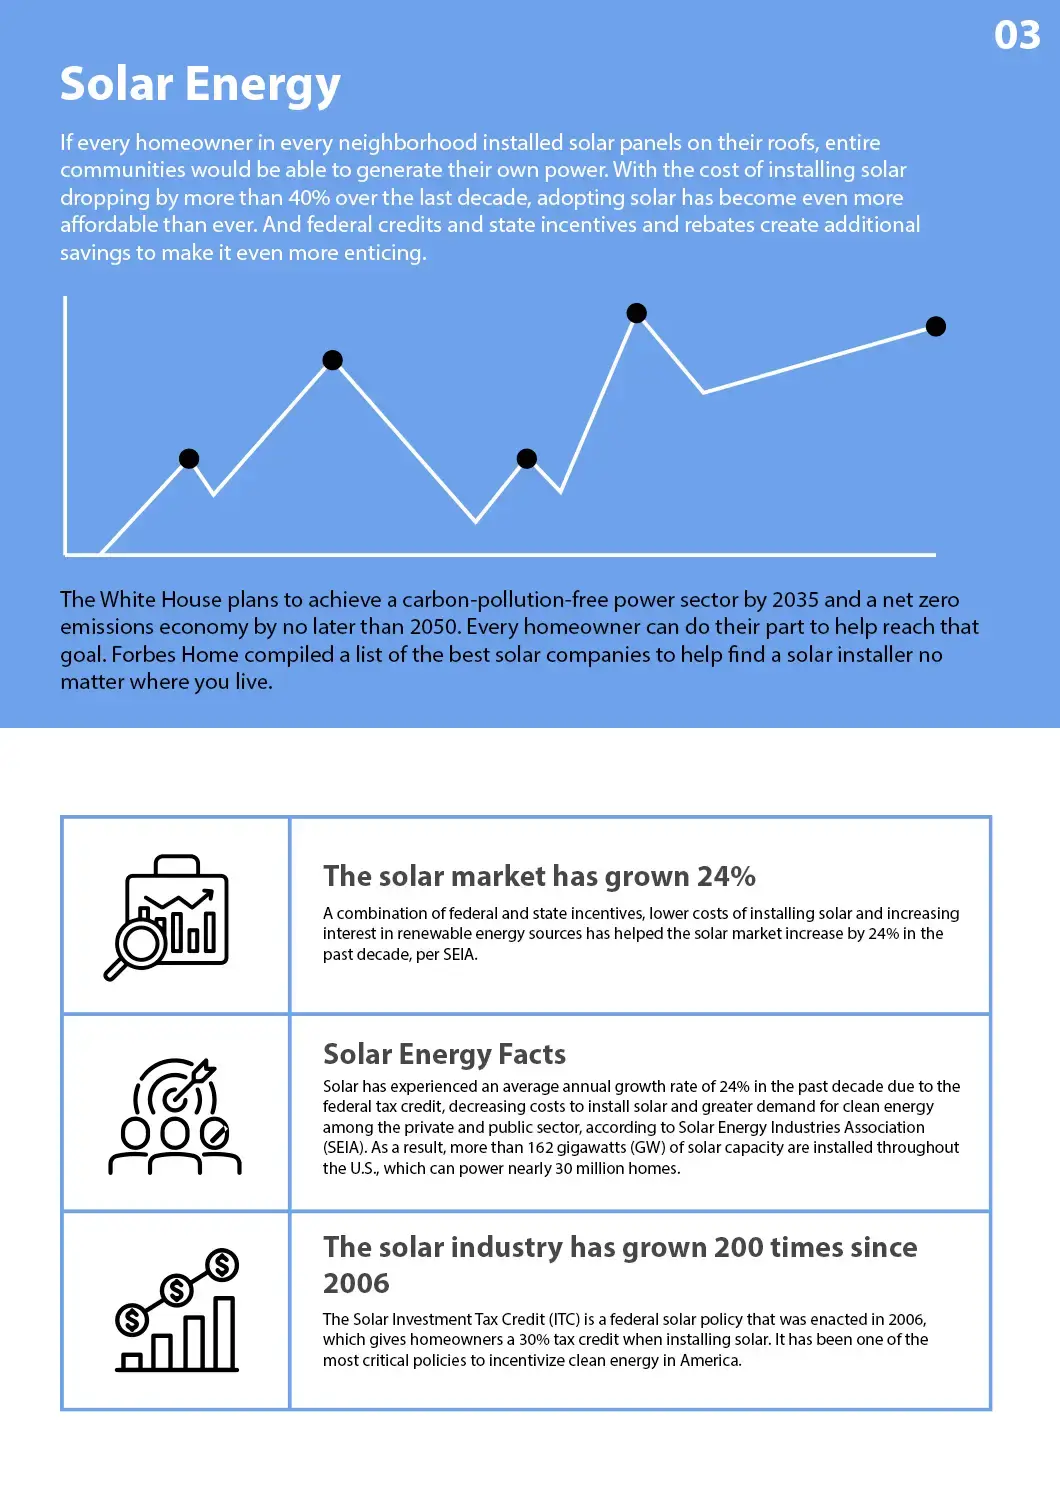
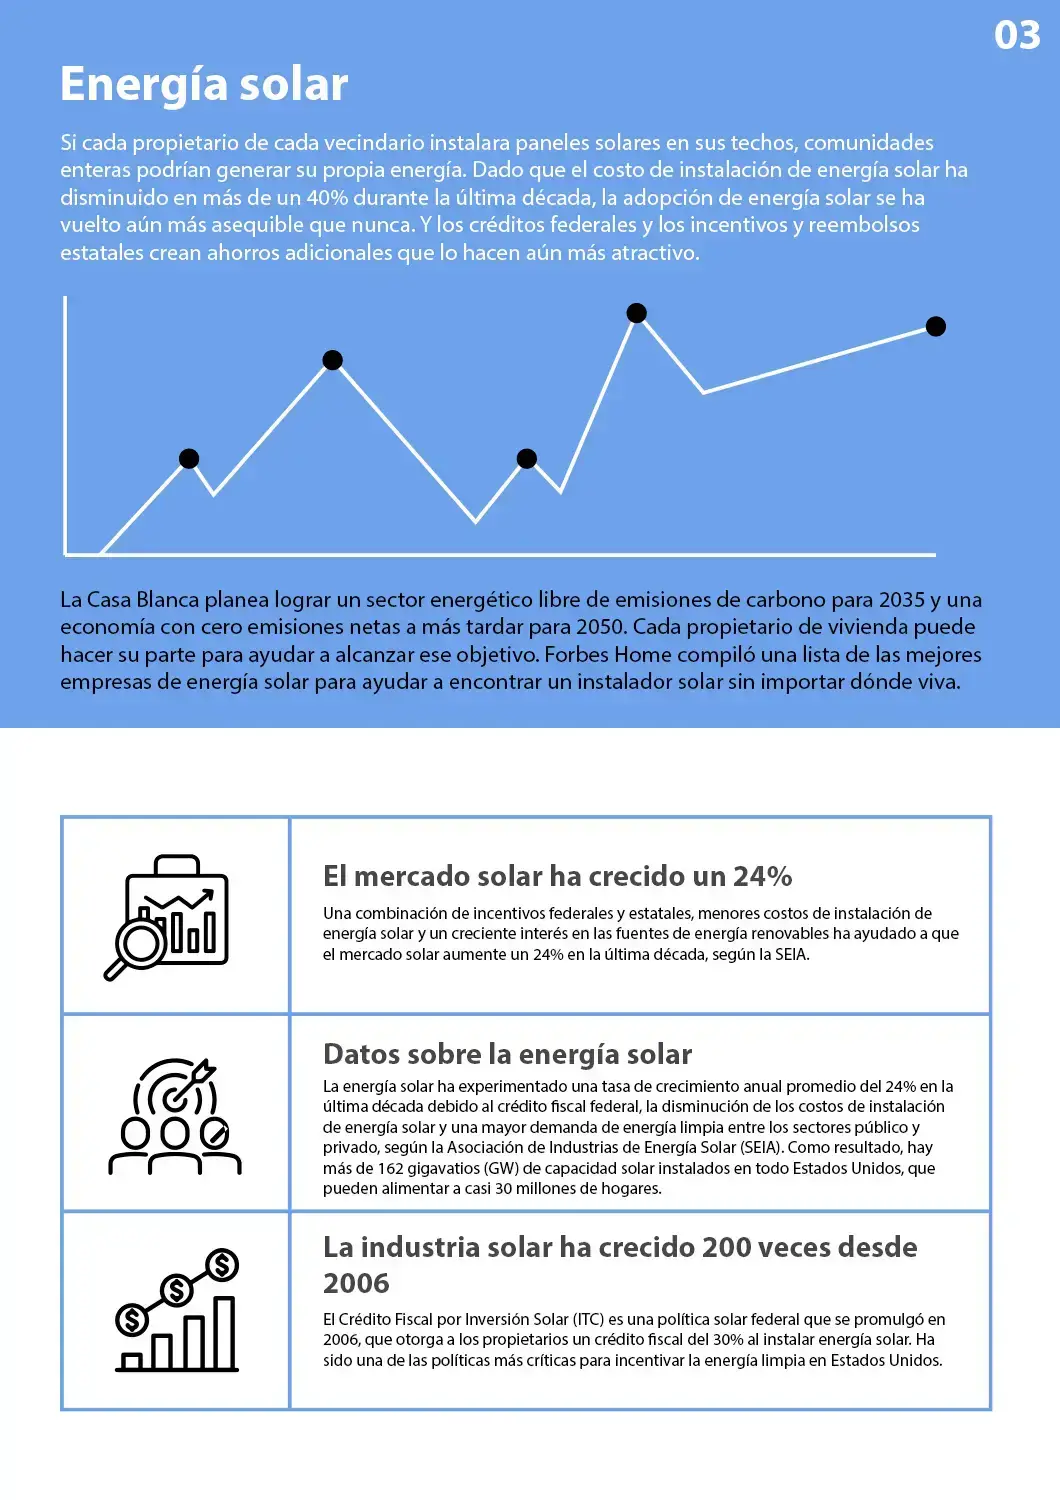
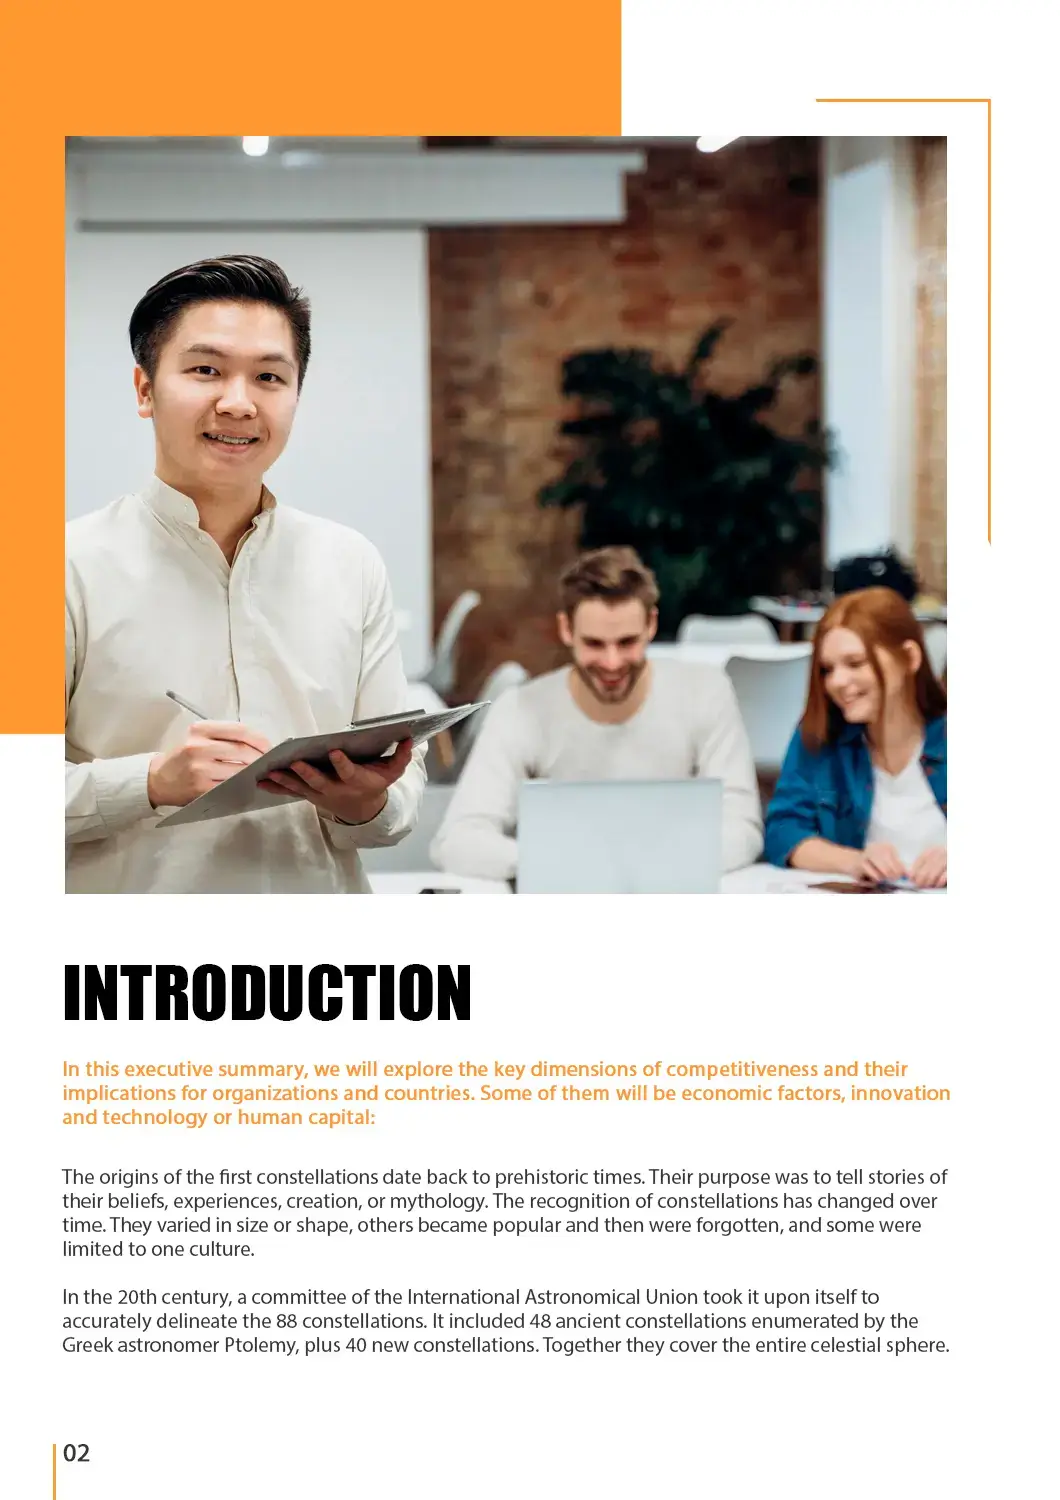
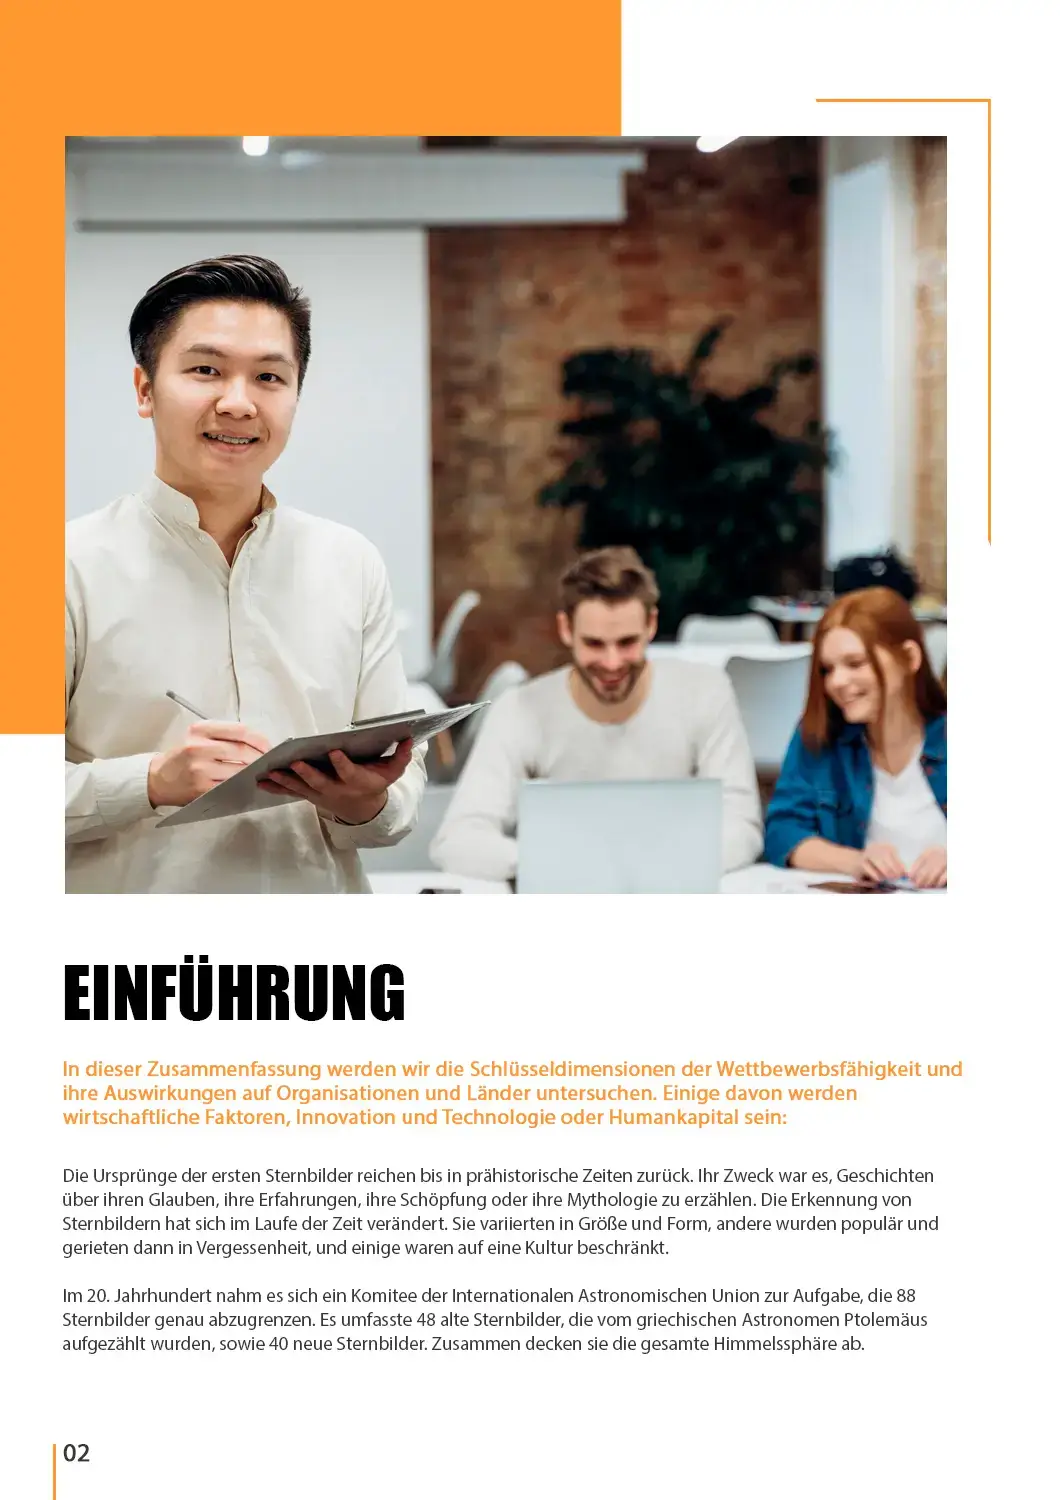
Niets hier werd geopend in een spreadsheet tussen de twee staten.
Bekijk alle vertaalvoorbeelden →Een werkende volgorde die herwerk vermijdt
Het lokaliseren van een catalogus is een pijplijn, en de dure fouten gebeuren allemaal aan de uiteinden ervan in plaats van in het midden.
- 1
Exporteer schoon en noteer de dialect
Neem de export rechtstreeks uit het systeem dat eigenaar is van de gegevens. Open het eenmaal in een platte teksteditor, niet in een spreadsheet, en noteer welk teken de velden scheidt en of waarden tussen aanhalingstekens staan.
- 2
Markeer de kolommen die je niet wilt laten aanpassen
Identifiers, sleutels, links, statuswaarden en codes. Als de export erg breed is, is het vaak sneller om deze te beperken tot de kolommen die proza bevatten en achteraf weer samen te voegen op de sleutel.
- 3
Upload en kies je talen
Maak een account aan met een e-mailadres, laat de gegevens vallen, en stel de bron- en doeltaal in. Uploads gaan tot 1 GB, dus een volledige catalogus wordt als één taak verwerkt in plaats van opgesplitst in batches.
- 4
Importeer eerst in een staging-kopie
Laad het resultaat in een testomgeving voordat u naar productie gaat. Controleer het aantal records ten opzichte van het origineel, bekijk de langste vertaalde waarden op layoutproblemen, en bevestig dat de accenttekens de reis hebben overleefd.
Vragen van mensen met datasets
Verandert de scheidingsteken als ik vertaal naar een taal die decimale komma's gebruikt?
De scheidingsteken die u hebt geüpload, is de scheidingsteken die u terugkrijgt. Het veranderen ervan zou betekenen dat de structuur wordt herschreven in plaats van de inhoud, en het zou verbreken wat de data aan de andere kant verbruikt. Als u specifiek een puntkomma-gescheiden versie nodig hebt omdat het resultaat wordt geopend in een spreadsheet op een machine die zo is geconfigureerd, converteer het dan na vertaling met een tool die beide dialecten begrijpt.
Hoe voorkom ik dat productcodes en identificaties worden vertaald?
Houd ze in duidelijk geïdentificeerde kolommen en stuur, waar mogelijk, alleen de prozokolommen voor verwerking en voeg ze achteraf weer samen op de sleutel. Waarden die duidelijk codes zijn in plaats van woorden, worden ongewijzigd gelaten, maar de veiligste regeling is degene waarbij de ambiguïteit nooit ontstaat. Laat een spreadsheet deze kolommen ondertussen nooit aanraken, omdat het ze opnieuw zal formatteren, ongeacht enige vertaling.
Mijn accenttekens kwamen terug als reeksen symbolen. Wat is er gebeurd?
Dat is een codering-mismatch, geen vertaalprobleem. Het resultaat is vrijwel zeker correcte Unicode die wordt gelezen door iets dat een legacy single-byte codering verwacht, of andersom. Open het in een teksteditor die u expliciet de codering laat kiezen en bevestig wat u daadwerkelijk hebt voordat u aanneemt dat er iets verloren is gegaan. Als een spreadsheet de bestemming is, bepaalt de byte order marker aan het begin meestal de instelling.
Wat gebeurt er met waarden die komma's of regeleinden bevatten?
Ze blijven ingesloten. Elke waarde die de scheidingsteken, een aanhalingsteken of een nieuwe regel bevat, moet worden omringd door aanhalingstekens, en een letterlijk aanhalingsteken binnen zo'n waarde moet worden verdubbeld. Omdat vertaalde tekst interpunctie kan krijgen die het origineel niet had, moet die omsluiting op het resultaat worden toegepast in plaats van van de bron te worden gekopieerd.
Zullen placeholders en variabele tokens behouden blijven?
Dat zouden ze moeten, en het is de moeite waard om een voorbeeld te controleren. Tokens zoals een procentteken gevolgd door een letter, een genummerde plek in accolades of een benoemde variabele zijn adressen voor waarden die tijdens runtime worden ingevoegd. Het vertalen ervan betekent dat de waarde het scherm nooit bereikt, dus scan een handvol van de langste interface-strings in de uitvoer voordat u verzendt.
Mijn strings worden veel langer in het Duits. Maakt dat hier uit?
Niet voor de data zelf, die geen breedte heeft. Het doet ertoe voor wat het weergeeft. Een uitbreiding van een vijfde tot een derde ten opzichte van het Engels is normaal voor Duits en Russisch, terwijl Chinees en Japans meestal krimpen. Sorteer de vertaalde kolom op lengte en kijk naar de extremen ten opzichte van uw eigen lay-out, en controleer elke databasekolom met een vaste tekenlimiet.
Hoe grote dataset kan ik in één keer versturen?
Tot 1 GB, of vijfduizend pagina's aan gelijkwaardige inhoud, op de Pro- en Business-abonnementen. Dat dekt catalogi met honderdduizenden rijen. Het geheel als één taak verzenden is ook beter voor consistentie, omdat een term die voorkomt in rij 12 en rij 90.000 op dezelfde manier wordt behandeld.
Waarvoor word ik gefactureerd bij een brede export?
De tekst, niet de tabel. Lege cellen, numerieke kolommen en identificatiekolommen zijn geen proza. Op Free wordt elk bestand afzonderlijk gefactureerd voor een halve cent per woord, met $0,99 als minimum, terwijl een abonnement put uit de pagina's die het elke 30 dagen bevat en pas daarna per woord factureert. Dat maakt een grote catalogus gemakkelijk te schatten op basis van een woordtelling.
Verstuur de export, behoud de structuur
Upload de gegevens precies zoals uw systeem ze heeft geproduceerd, kies de doeltaal en ontvang een raster terug met hetzelfde aantal kolommen in elk record en de sleutels nog steeds koppelbaar.
Onze Partners


Gerelateerde Vertaaldiensten
Bestandsformaten
PDF Tools
Populaire Taalcombinaties