
CSV Vertaal Dienste
Produkkatalogusse, uitvoere en datastelle word kolom vir kolom vertaal, met die skeiers, die aanhalingstekens en die identifiseerderkolomme wat presies gelaat word soos jou parser verwag om dit te vind.
Laai dokument op of sleep dit hierheen om te vertaal
Maks. lêergrootte 1 GB
Die struktuur word deur twee karakters ondersteun
Koma-geskeide waardes is skaars 'n formaat. Daar is 'n wyd gevolgde beskrywing van die algemene dialek, maar geen gesag dwing dit af nie, so wat jy eintlik ontvang is een van verskeie konvensies. Die hele rooster rus op twee besluite: watter karakter skei die velde in 'n rekord, en watter volgorde beëindig 'n rekord. Kry enige een verkeerd en 'n netjiese tabel word 'n enkele ongelyke kolom.
Die skeier is nie altyd 'n komma nie. Sigblad sagteware in lande wat desimale met 'n komma skryf, verstek na 'n semikolon in plaas daarvan, en dit is hoekom 'n uitvoer van 'n Duitse of Franse masjien dikwels weier om skoon elders oop te maak. Tabs en vertikale stawe word albei algemeen gebruik, gewoonlik juis gekies omdat die inhoud vol kommas is.
Elke rekord moet dieselfde aantal velde as die kopteks dra, want daardie telling is hoe 'n parser weet watter waarde aan watter kolom behoort. Niks in die data kondig dit aan nie. Dit is 'n konstante wat óf hou, óf stilweg ophou hou halfpad deur 'n groot uitvoer, op watter punt alles daaronder een kolom na links skuif en plausibel lyk.
Vier maniere waarop vertaalde teks 'n rekord breek
Dit is die mislukkings wat hulself nie aankondig nie. Die uitvoer maak steeds oop, die ry-telling lyk steeds ongeveer reg, en die skade verskyn later in wat ook al die data verbruik.
- 'n Nuwe skeier verskyn binne 'n waarde. 'n Engelse produkbeskrywing sonder kommas word 'n Franse een met twee. As die veld nie voorheen aangehaal is nie, moet dit nou wees, anders lees die parser een waarde as drie en skuif elke kolom daarna.
- 'n Aanhalingsteken land binne 'n aangehaalde waarde. Binne 'n ingeslote veld moet 'n letterlike dubbele aanhalingsteken twee keer geskryf word om homself te ontsnap. Tale wat met verskillende merke aanhaal, en enige proses wat reguit merke na tipografiese omvorm, kan 'n ontsnapte karakter in die middel van 'n waarde laat sit waar dit die veld vroegtydig beëindig.
- 'n Lynbreek kruip in 'n sel. 'n Rekord eindig by 'n nuwe lyn tensy daardie nuwe lyn binne aanhalingstekens sit. Vertaalde bemarkingskopie wat 'n paragraafbreuk kry, sal een rekord in twee verdeel, en die tweede helfte sal die verkeerde aantal velde hê.
- 'n Plekhouer word vertaal. Stelle wat vir sagteware bestem is, bevat dikwels substitusie-tokens, 'n persentasieteken gevolg deur 'n letter, 'n genommerde gleuf in hakies, 'n benoemde veranderlike. Hulle is adresse vir waardes wat tydens looptyd ingevoeg word, nie woorde nie, en om een te vertaal beteken dat die waarde nooit verskyn nie.
Half van jou kolomme is nie taal nie
'n Datastel meng prosa bedoel vir mense met sleutels bedoel vir masjiene, en hulle sit langs mekaar met niks om hulle te onderskei behalwe die kolomopskrif nie. Werk uit watter een watter is voordat jy begin, want 'n vertaalde identifiseerder is erger as 'n onvertaalde beskrywing.
Los hierdie alleen
- Die kopteks self waar die opskrifte veldname is wat deur kode gebruik word eerder as etikette wat aan 'n persoon gewys word
- Voorraadkodes, katalogusnommers, unieke identifiseerders en enigiets wat as 'n sleutel gebruik word om twee datastelle te koppel
- Webadresse en die slakgedeelte van een, aangesien die verandering daarvan die skakel en sy ranglys breek
- Statuswaardes wat sagteware vergelyk met 'n vaste lys, soos 'n bestellingstatus of 'n ja-en-nee-vlag
- Land-, taal- en geldeenheidkodes, wat reeds gestandaardiseerde afkortings is
- Datums geskryf in jaar-maand-dag volgorde, nommers, en enigiets wat gepars sal word eerder as gelees
Dit is waarna jy gesoek het
- Produk titels en lang beskrywings, wat gewoonlik die grootste deel van die woordtelling is
- Kategorie en versameling name soos klante dit sien
- Attribuut waardes met betekenis, soos 'n kleur, 'n materiaal of 'n grootte woord
- Koppelvlak stringe wat vir lokalisering uitgetrek is, minus hul plekhouers
- Ondersteuningsartikel liggame, vooraf ingestelde antwoorde en e-pos sjablone gehou as rye
- Kolomopskrifte waar die uitvoer bedoel is om deur 'n persoon eerder as 'n program oopgemaak te word
Twee dinge wat data beskadig voordat vertaling eers begin
Dit oopmaak in 'n sigblad
Dubbelklik op 'n uitvoer en dit weer stoor is die mees betroubare manier om 'n katalogus te korrup. Sigblad sagteware raai die tipe van elke waarde wat dit sien, en sy raaiskote is selfversekerd en verkeerd:
- 'n Dertien-syfer artikelnommer verander in wetenskaplike notasie en verloor sy laaste syfers vir goed
- 'n Poskode wat met 'n nul begin, verloor die nul
- Enigiets wat soos 'n dag en 'n maand lyk, word herskryf as 'n datum in die plaaslike formaat
- Lang identifikasies verby vyftien syfers word afgerond, stilswyend
As jy die data eers moet inspekteer, gebruik die invoer dialoog en stel die identifikasie kolomme na teks eerder as om die program te laat besluit. Nog beter, laai die uitvoer presies op soos jou stelsel dit geproduseer het.
Die byte order mark vraag
Niks binne die data sê watter karakterkodering dit gebruik nie, so 'n merker van drie grepe word soms aan die heel begin geplaas om een te sein. Daardie merker help en skaad afhangende van wat die data volgende oopmaak.
Sigblad sagteware op Windows gebruik dit om Unicode inhoud te herken, en sonder dit kom aksent en nie-Latynse karakters uit as stringe van simbole. Baie programmerings biblioteke, daarenteen, verwyder dit nie, so die eerste kolom opskrif kom aan met drie onsigbare karakters vasgeplak aan die voorkant en elke opsoek teen daardie opskrif misluk.
Besluit deur bestemming: hou die merker as 'n persoon die resultaat in 'n sigblad sal oopmaak, laat dit val as 'n program dit sal lees. Die antwoord op byna elke vraag oor gekorrupteerde aksent karakters is iewers in hierdie paragraaf.
Wat 'n datastel kos om te verwerk
Geprys per volume van teks, so 'n wye katalogus met kort waardes is goedkoper as 'n nou een vol lang beskrywings.
Free
Geen kaart nodig om te registreer nie
- $0.005/woord KI-vertaling
- $1 per bladsy vir skanderings en beeld-PDF's
- 120+ tale
- Lêers tot 20 MB en 20 bladsye
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- 24-uur lêerstoor slegs
- PDF-redigeerder en PDF na DOCX-omskakelaar
- Kanselleer enige tyd
- Nie ingesluit nie: E-pos ondersteuning
- Nie ingesluit nie: Span toegang
- Nie ingesluit nie: Onbeperkte gratis PDF-voorbeskouings
- Nie ingesluit nie: Glosarium
Storage
of $149/jaar
- $0.005/woord KI-vertaling
- $1 per bladsy vir skanderings en beeld-PDF's
- 120+ tale
- Lêers tot 100 MB en 100 bladsye
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- Onbeperkte lêerstoor
- PDF-redigeerder en PDF na DOCX-omskakelaar
- E-pos ondersteuning
- Kanselleer enige tyd
- Nie ingesluit nie: Span toegang
- Nie ingesluit nie: Onbeperkte gratis PDF-voorbeskouings
- Nie ingesluit nie: Glosarium
Pro
of $499/jaar
- $0.004/woord KI-vertaling
- $0.80 per bladsy vir skanderings en beeld-PDF's
- 120+ tale
- Lêers tot 1000 MB en 5000 bladsye
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG en CSV
- Onbeperkte lêerstoor
- PDF-redigeerder en PDF na DOCX-omskakelaar
- E-pos ondersteuning
- Span toegang vir tot 5 lede
- Onbeperkte gratis PDF-voorbeskouings
- Glosarium
- Kanselleer enige tyd
Onderneming
$149.99/maand, op aanvraag. KI-vertaling teen $0.003/woord ($0.60 per bladsy), lêers tot 1000 MB en 5000 bladsye, onbeperkte lêerstoor en span toegang vir tot 15 lede.
Rye in, rye uit
Vergroot 'n duimnael om 'n bron bladsy met sy resultaat te vergelyk. Wat die pare demonstreer:
- Kolom telling per rekord bly onveranderd van bo na onder.
- Waardes wat in aanhalings ingesluit was, is steeds ingesluit.
- Kodes, sleutels en numeriese waardes gaan ongeskonde deur.
- Slegs die menslik-leesbare kolomme kom terug in 'n nuwe taal.
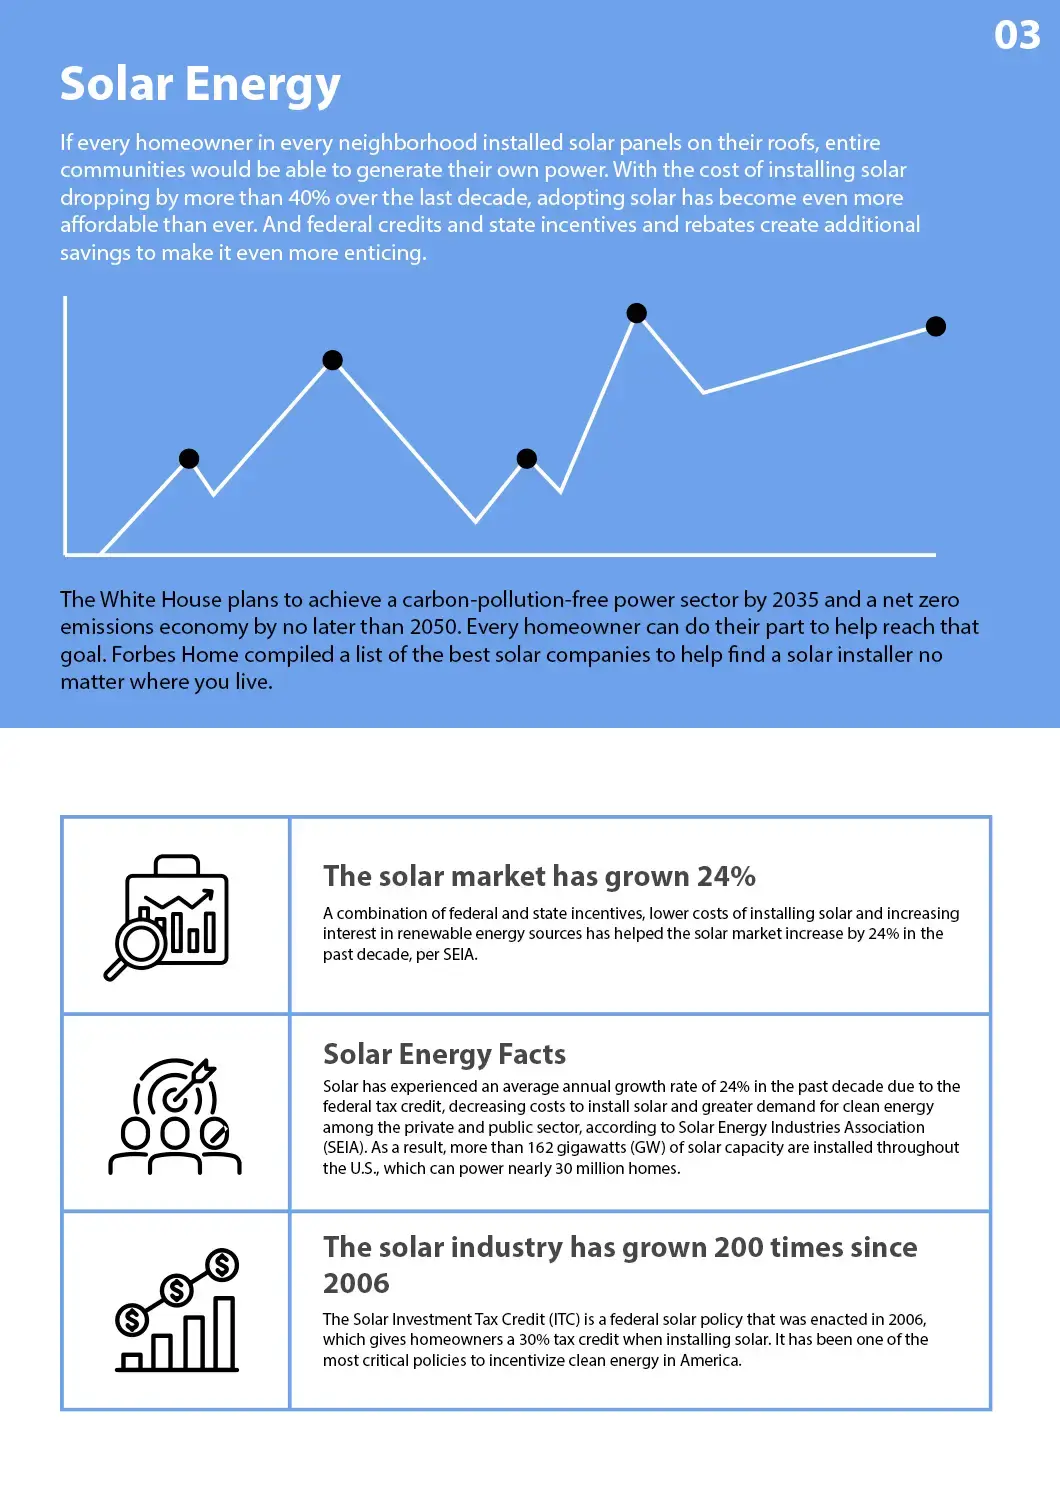
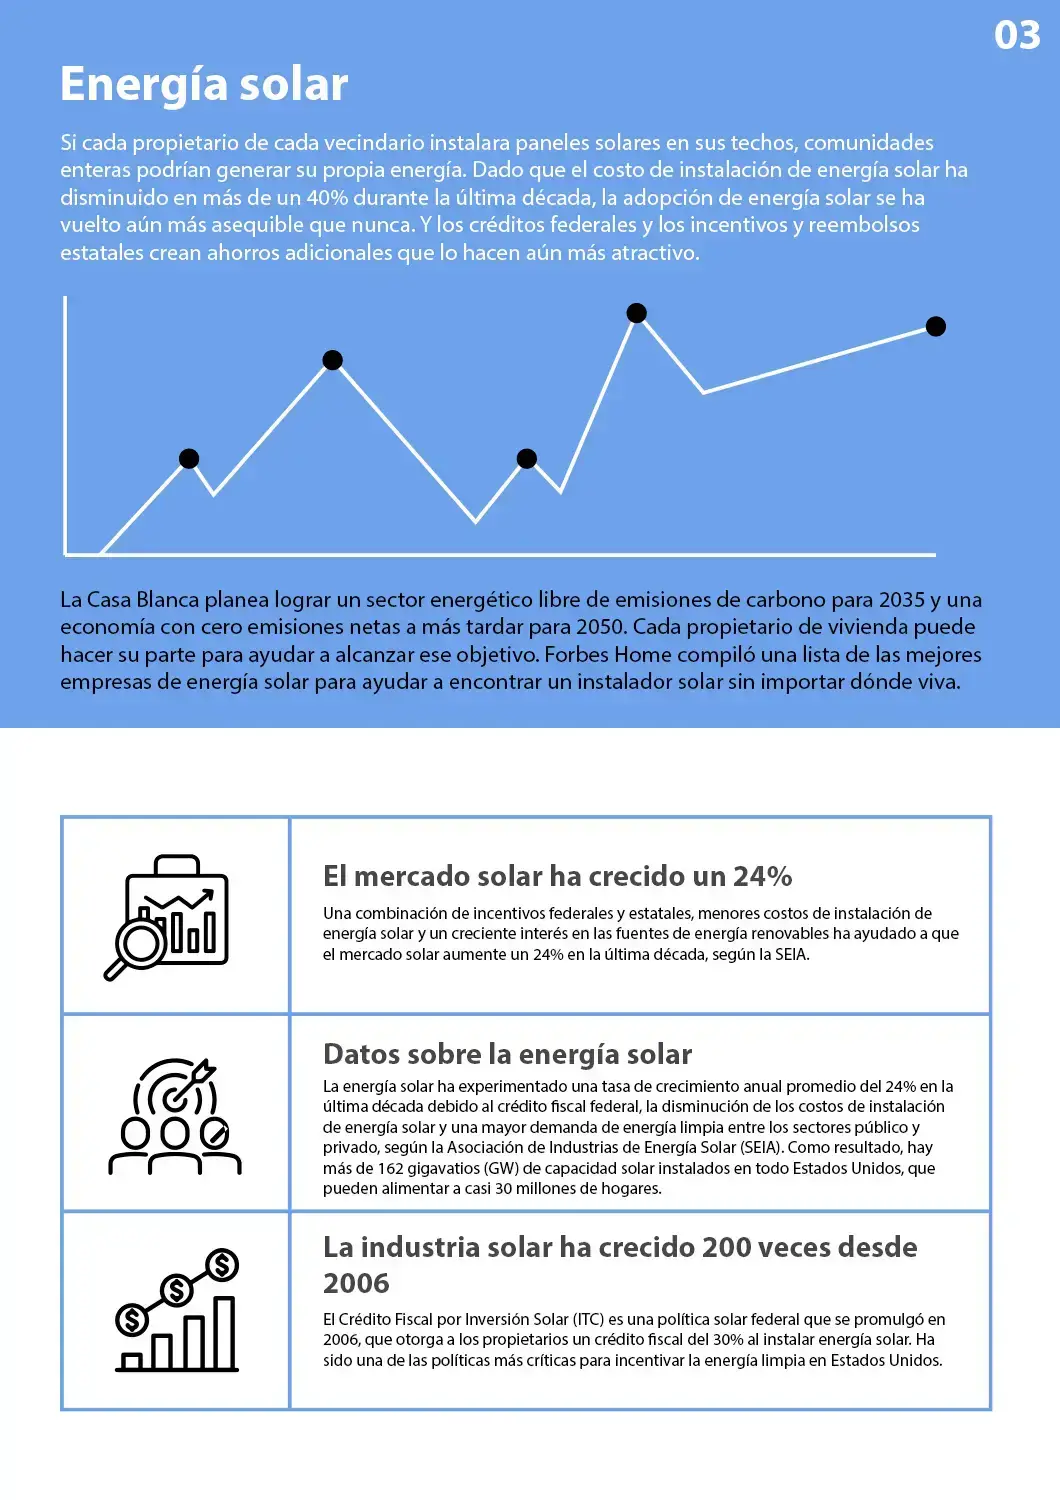
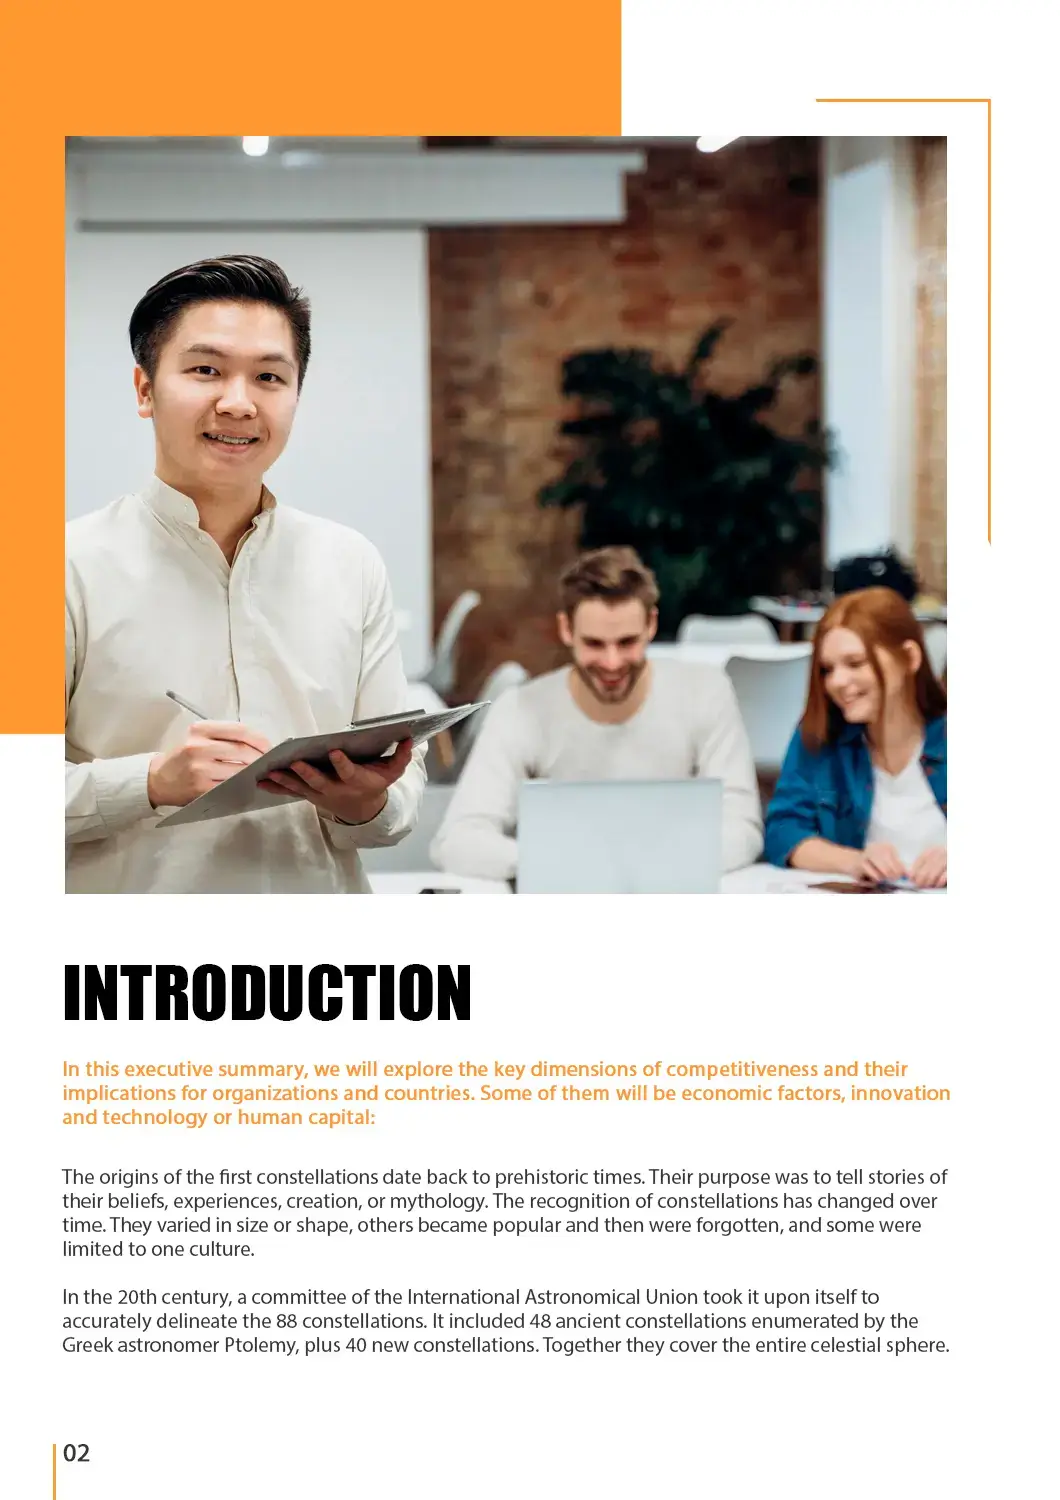
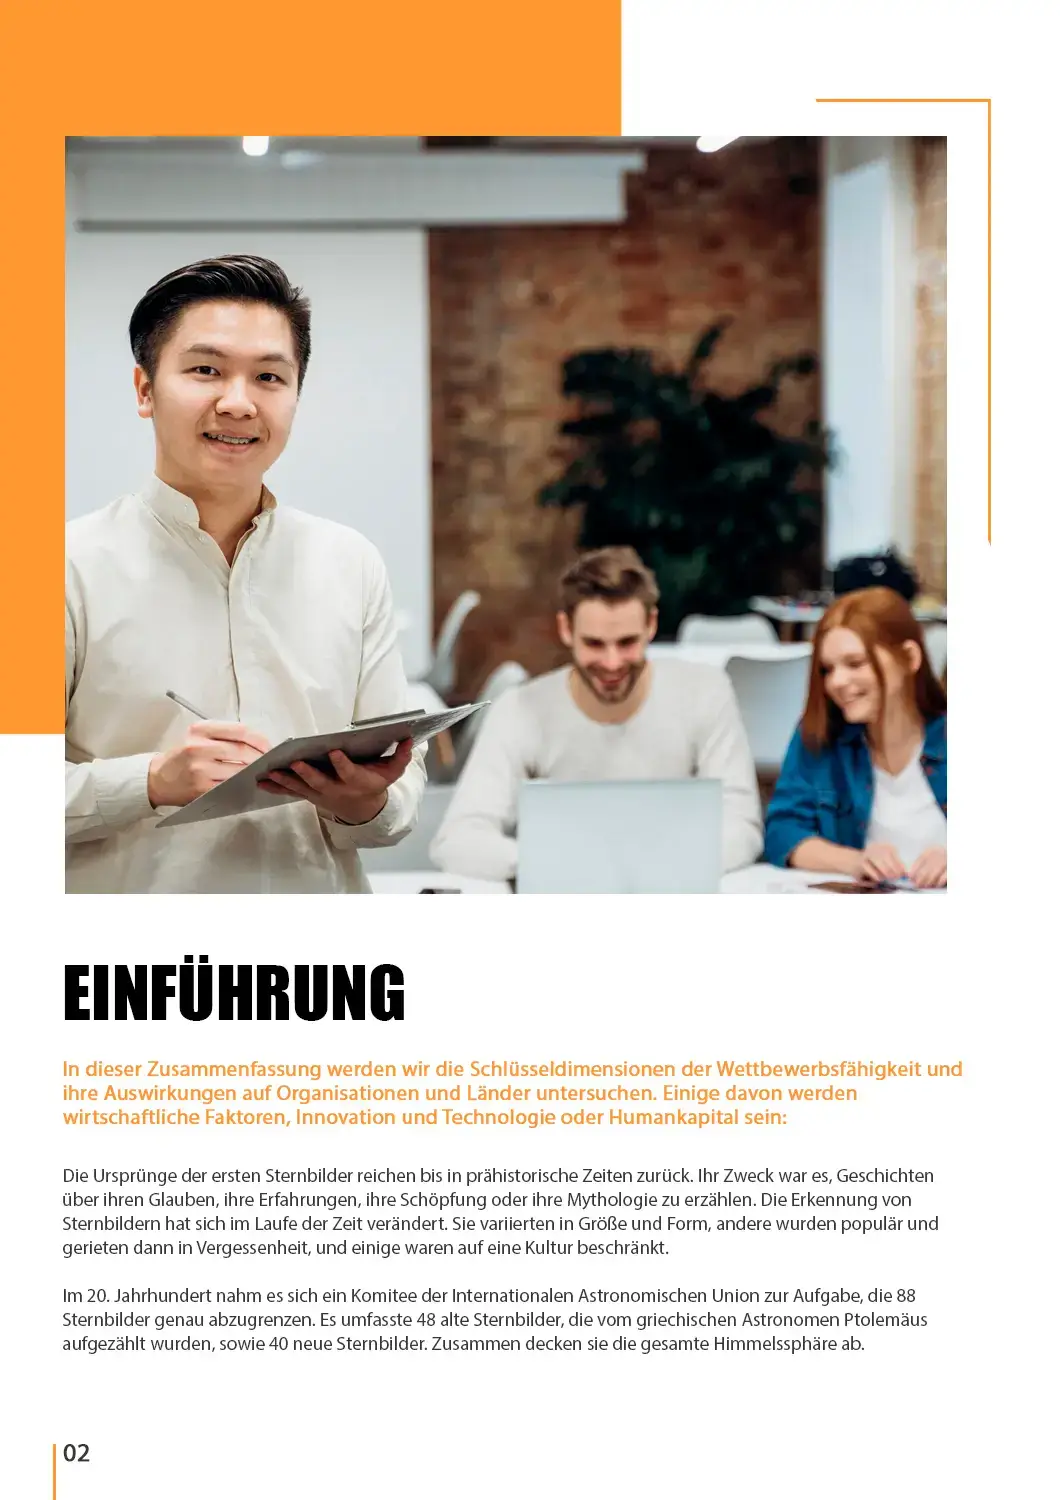
Niks hier is in 'n sigblad oopgemaak tussen die twee state nie.
Sien alle vertaalvoorbeelde →'n Werkende volgorde wat herwerk vermy
Die lokalisering van 'n katalogus is 'n pyplyn, en die duur foute gebeur almal aan die ente daarvan eerder as in die middel.
- 1
Voer skoon uit en let die dialek op
Neem die uitvoer direk uit die stelsel wat die data besit. Maak dit een keer oop in 'n gewone teksredigeerder, nie 'n sigblad nie, en let op watter karakter die velde skei en of waardes in aanhalings ingesluit is.
- 2
Merk die kolomme wat jy nie wil hê om aangeraak te word nie
Identifikasies, sleutels, skakels, status waardes en kodes. As die uitvoer baie wyd is, is dit dikwels vinniger om dit af te sny tot die kolomme wat prosa bevat en daarna weer aan te sluit op die sleutel.
- 3
Laai op en kies jou tale
Skep 'n rekening met 'n e-posadres, laat val die data in, en stel die bron en teiken in. Oplaaie loop tot 1 GB, so 'n volledige katalogus gaan deur as een taak eerder as om in bondels op te deel.
- 4
Herinvoer eers in 'n staging-kopie
Laai die resultaat in 'n toetsomgewing voor produksie. Kontroleer die rekordtelling teenoor die oorspronklike, kyk na die langste vertaalde waardes vir uitlegprobleme, en bevestig dat die aksenttekens die reis oorleef het.
Vrae van mense met datastelle
Verander die skeier as ek na 'n taal vertaal wat desimale kommas gebruik?
Die skeier waarmee jy opgelaai het, is die skeier wat jy terugkry. Om dit te verander, sal beteken dat die struktuur herskryf word eerder as die inhoud, en dit sal breek wat ook al die data aan die ander kant verbruik. As jy spesifiek 'n puntkomma-geskeide weergawe benodig omdat die resultaat in 'n sigblad op 'n masjien wat so gekonfigureer is, oopgemaak sal word, skakel dit om na vertaling met 'n hulpmiddel wat albei dialekte verstaan.
Hoe keer ek dat produk kodes en identifikasies vertaal word?
Hou hulle in duidelik geïdentifiseerde kolomme en, waar moontlik, stuur slegs die prosa kolomme vir verwerking en voeg weer aan die sleutel daarna saam. Waardes wat ooglopend kodes eerder as woorde is, word gelaat soos hulle is, maar die veiligste rangskikking is die een waar die ambiguïteit nooit ontstaan nie. Moet nooit toelaat dat 'n sigblad daardie kolomme intussen aanraak nie, want dit sal hulle hervorm ongeag enige vertaling.
My aksent karakters het teruggekom as stringe simbole. Wat het gebeur?
Dit is 'n kodering-mismatchen, nie 'n vertaalprobleem nie. Die resultaat is byna sekerlik korrekte Unicode wat gelees word deur iets wat 'n ou enkel-byte kodering verwag, of andersom. Maak dit oop in 'n teksredigeerder wat jou toelaat om die kodering eksplisiet te kies en bevestig wat jy eintlik het voordat jy aanneem dat iets verlore gegaan het. As 'n sigblad die bestemming is, is die byte-orde-merk aan die begin gewoonlik wat dit bepaal.
Wat gebeur met waardes wat kommas of lynbreuke bevat?
Hulle bly ingesluit. Enige waarde wat die skeier, 'n aanhalingsteken of 'n nuwe lyn bevat, moet in aanhalings toegedraai word, en 'n letterlike aanhalingsteken binne so 'n waarde moet verdubbel word. Omdat vertaalde teks leestekens kan verkry wat die oorspronklike nie gehad het nie, moet daardie insluiting op die resultaat toegepas word eerder as om van die bron gekopieer te word.
Sal plekhouers en veranderlike tokens oorleef?
Hulle behoort, en dit is die moeite werd om 'n voorbeeld na te gaan. Tokens soos 'n persentasieteken gevolg deur 'n letter, 'n genommerde gleuf in hakies of 'n benoemde veranderlike is adresse vir waardes wat tydens die uitvoering ingevoeg word. Om een te vertaal beteken dat die waarde nooit die skerm bereik nie, so skandeer 'n handvol van die langste koppelvlakstringe in die uitvoer voordat jy verskeep.
My stringe word baie langer in Duits. Maak dit hier saak?
Nie vir die data self nie, wat geen breedte het nie. Dit maak saak vir wat dit vertoon. Uitbreiding van 'n vyfde tot 'n derde oor Engels is normaal vir Duits en Russies, terwyl Chinees en Japannees gewoonlik inkontrakteer. Sorteer die vertaalde kolom volgens lengte en kyk na die uiterstes teen jou eie uitleg, en kontroleer enige databasis kolom met 'n vaste karakterlimiet.
Hoe groot 'n datastel kan ek in een slag stuur?
Tot 1 GB, of vyfduisend bladsye van ekwivalente inhoud, op die Pro en Enterprise-planne. Dit dek katalogusse in die honderde duisende rye. Om die hele ding as een taak te stuur is ook beter vir konsekwentheid, want 'n term wat in ry 12 en ry 90 000 voorkom, word op dieselfde manier hanteer.
Waarvoor word ek op 'n wye uitvoer gehef?
Die teks, nie die rooster nie. Leë selle, numeriese kolomme en identifikasiekolomme is nie prosa nie. Elke lêer word op sy eie gefaktureer, aangesien geen plan woorde gebundel het nie: 'n halwe sent per woord op Free en Storage, $0.004 op Pro en $0.003 op Enterprise, met $0.99 as die vloer. Dit maak 'n groot katalogus maklik om te skat uit 'n woordtelling.
Stuur die uitvoer, behou die struktuur
Laai die data presies so op soos jou stelsel dit geproduseer het, kies die teikentaal, en kry 'n rooster terug met dieselfde aantal kolomme in elke rekord en die sleutels wat steeds gekoppel kan word.
Ons Vennote


Verwante Vertalingsdienste
Lêerformate
PDF Gereedskap