
Перекладач CSV
Каталоги продукції, експорти та набори даних перекладаються стовпець за стовпцем, а роздільники, лапки та стовпці ідентифікаторів залишаються точно такими, як очікує ваш парсер.
Завантажте або перетягніть документ для перекладу
Макс. розмір файлу 1 ГБ
- OCR для сканів та фотографій
- 108 мов
- Оригінальний макет збережено
Структура підтримується двома символами
Значення, розділені комою, — це ледь формат. Існує широко поширений опис загального діалекту, але немає авторитету, який би його забезпечував, тому те, що ви фактично отримуєте, є однією з кількох конвенцій. Вся сітка спирається на два рішення: який символ розділяє поля в записі, і яка послідовність закінчує запис. Помилка в будь-якому з них перетворює акуратну таблицю на один нерівний стовпець.
Роздільник не завжди кома. Програмне забезпечення для електронних таблиць у країнах, де десяткові знаки записуються комою, за замовчуванням використовує крапку з комою, тому експорт з німецької чи французької машини часто не відкривається належним чином в інших місцях. Табуляція та вертикальні риски також широко використовуються, зазвичай обираються саме тому, що вміст сповнений ком.
Кожен запис повинен містити ту саму кількість полів, що й заголовок, оскільки ця кількість — це те, як парсер знає, яке значення належить до якого стовпця. У даних немає нічого, що б це оголошувало. Це інваріант, який або дотримується, або мовчки перестає дотримуватися на середині великого експорту, після чого все нижче зміщується на один стовпець вліво і виглядає правдоподібно.
Чотири способи, якими перекладений текст руйнує запис
Це збої, які не оголошують себе. Експорт все ще відкривається, кількість рядків все ще виглядає приблизно правильною, і пошкодження з'являється пізніше в будь-чому, що споживає дані.
- Новий роздільник з'являється всередині значення. Англійський опис продукту без ком стає французьким з двома. Якщо поле раніше не було в лапках, тепер воно повинно бути, інакше парсер читає одне значення як три і зміщує кожен стовпець після нього.
- Знак лапок потрапляє всередину значення в лапках. Всередині закритого поля, буквальна подвійна лапка повинна бути написана двічі, щоб уникнути себе. Мови, які використовують різні лапки, і будь-який процес, що перетворює прямі лапки на типографські, можуть залишити незакритий символ посередині значення, де він передчасно закінчує поле.
- Розрив рядка потрапляє в комірку. Запис закінчується на новому рядку, якщо цей новий рядок не знаходиться в лапках. Перекладений маркетинговий текст, який отримує розрив абзацу, розділить один запис на два, і друга половина матиме неправильну кількість полів.
- Перекладено заповнювач. Рядки, призначені для програмного забезпечення, часто містять маркери заміщення: знак відсотка, за яким слідує літера, пронумерований слот у фігурних дужках, іменована змінна. Це адреси для значень, що вставляються під час виконання, а не слова, і переклад одного означає, що значення ніколи не з'явиться.
Половина ваших стовпців — це не мова
Набір даних змішує прозу, призначену для людей, з ключами, призначеними для машин, і вони розташовані поруч, не маючи нічого, що б їх відрізняло, крім заголовка стовпця. З'ясуйте, що є що, перш ніж почати, тому що перекладений ідентифікатор гірший за неперекладений опис.
Залиште це
- Рядок заголовка, де заголовки є іменами полів, що використовуються кодом, а не мітками, показаними людині
- Коди товарів, номери каталогів, унікальні ідентифікатори та будь-що, що використовується як ключ для об'єднання двох наборів даних
- Веб-адреси та частина URL-адреси, оскільки її зміна порушує посилання та його рейтинг
- Значення статусу, які програмне забезпечення порівнює з фіксованим списком, наприклад, стан замовлення або прапорець так/ні
- Коди країни, мови та валюти, які вже є стандартизованими скороченнями
- Дати, написані в порядку рік-місяць-день, числа та все, що буде розібрано, а не прочитано
Це ті, заради яких ви прийшли
- Назви продуктів та довгі описи, що зазвичай становить більшу частину обсягу тексту
- Назви категорій та колекцій, як їх бачать клієнти
- Значення атрибутів зі змістом, такі як колір, матеріал або розмір
- Рядки інтерфейсу, витягнуті для локалізації, за винятком їхніх плейсхолдерів
- Тіла статей підтримки, стандартні відповіді та шаблони електронних листів, що зберігаються як рядки
- Заголовки стовпців, де експорт призначений для відкриття людиною, а не програмою
Дві речі, які пошкоджують дані ще до початку перекладу
Відкриття у електронній таблиці
Подвійне клацання експорту та його повторне збереження — найнадійніший спосіб зіпсувати каталог. Програмне забезпечення для електронних таблиць вгадує тип кожного значення, яке воно бачить, і його здогадки впевнені та неправильні:
- Тринадцятизначний номер статті перетворюється на наукову нотацію та назавжди втрачає останні цифри
- Поштовий індекс, що починається з нуля, втрачає нуль
- Все, що нагадує день і місяць, перезаписується як дата в локальному форматі
- Довгі ідентифікатори, що перевищують п'ятнадцять цифр, мовчки округлюються
Якщо вам потрібно спочатку переглянути дані, скористайтеся діалогом імпорту та встановіть стовпці ідентифікаторів як текст, а не дозволяйте програмі вирішувати. Ще краще — завантажте експорт саме так, як його створила ваша система.
Питання про маркер порядку байтів
Ніщо всередині даних не вказує, яку кодування символів вони використовують, тому маркер із трьох байтів іноді розміщується на самому початку, щоб сигналізувати про одне. Цей маркер допомагає і шкодить залежно від того, що відкриває дані далі.
Програмне забезпечення для електронних таблиць у Windows використовує його для розпізнавання вмісту Unicode, і без нього символи з діакритикою та нелатинські символи виходять як рядки символів. Багато програмних бібліотек, навпаки, не видаляють його, тому перший заголовок стовпця надходить із трьома невидимими символами, приклеєними спереду, і кожен пошук за цим заголовком не вдається.
Вирішуйте залежно від призначення: збережіть маркер, якщо результат відкриватиме людина в електронній таблиці, видаліть його, якщо дані читатиме програма. Відповідь майже на кожне запитання про пошкоджені символи з діакритикою знаходиться десь у цьому абзаці.
Скільки коштує обробка набору даних
Ціна залежить від обсягу тексту, тому широкий каталог із короткими значеннями дешевший, ніж вузький, повний довгих описів.
Free
Для реєстрації картка не потрібна
- 0,005 $/слово ШІ-переклад
- 1 долар за сторінку для сканів та PDF із зображеннями
- 108 мов
- Файли до 20 МБ та 20 сторінок
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG та CSV
- Лише 24-годинне зберігання файлів
- Редактор PDF та конвертер PDF у DOCX
Базовий
НайпопулярнішийОплата щотижня · скасувати будь-коли
Оплата щомісяця
Оплата раз на рік · заощаджуйте 33%
- ШІ-переклад включено щомісяця
- Потім 0,005 $/слово ШІ-переклад
- Файли до 100 МБ та 300 сторінок
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG та CSV
- OCR для сканованих документів
- Зберігання документів
- Пріоритетна підтримка
- 7-денна безкоштовна пробна версія за щомісячним планом
- Скасувати будь-коли
Pro
Оплата щомісяця
Оплата раз на рік · заощаджуйте 34%
- ШІ-переклад включено щомісяця
- Потім 0,004 $/слово ШІ-переклад
- Файли до 1 ГБ та 5000 сторінок
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG та CSV
- Глосарій
- Пріоритетна черга
- 5 місць для команди
- Запити до API · 1000 сторінок на місяць
- Доступ до MCP для ШІ-асистентів
- Скасувати будь-коли
Бізнес
Оплата щомісяця
Оплата раз на рік · заощаджуйте 33%
- ШІ-переклад включено щомісяця
- Потім 0,003 $/слово ШІ-переклад
- Файли до 1 ГБ та 5000 сторінок
- DOCX, PDF, XLSX, PPTX, IDML, TXT, JPG, PNG та CSV
- Глосарій
- Пріоритетна черга
- 15 місць для команди
- Запити до API · 5000 сторінок на місяць
- Доступ до MCP для ШІ-асистентів
- Скасувати будь-коли
Для бізнесу
Потрібен більший обсяг, виставлення рахунків або індивідуальна угода? Поговоріть з нами про план Enterprise.
Рядки на вході, рядки на виході
Збільште мініатюру, щоб порівняти вихідну сторінку з її результатом. Що демонструють пари:
- Кількість стовпців на запис залишається незмінною зверху донизу.
- Значення, які були взяті в лапки, як і раніше, залишаються в лапках.
- Коди, ключі та числові значення проходять без змін.
- Лише стовпці, призначені для читання людиною, повертаються новою мовою.
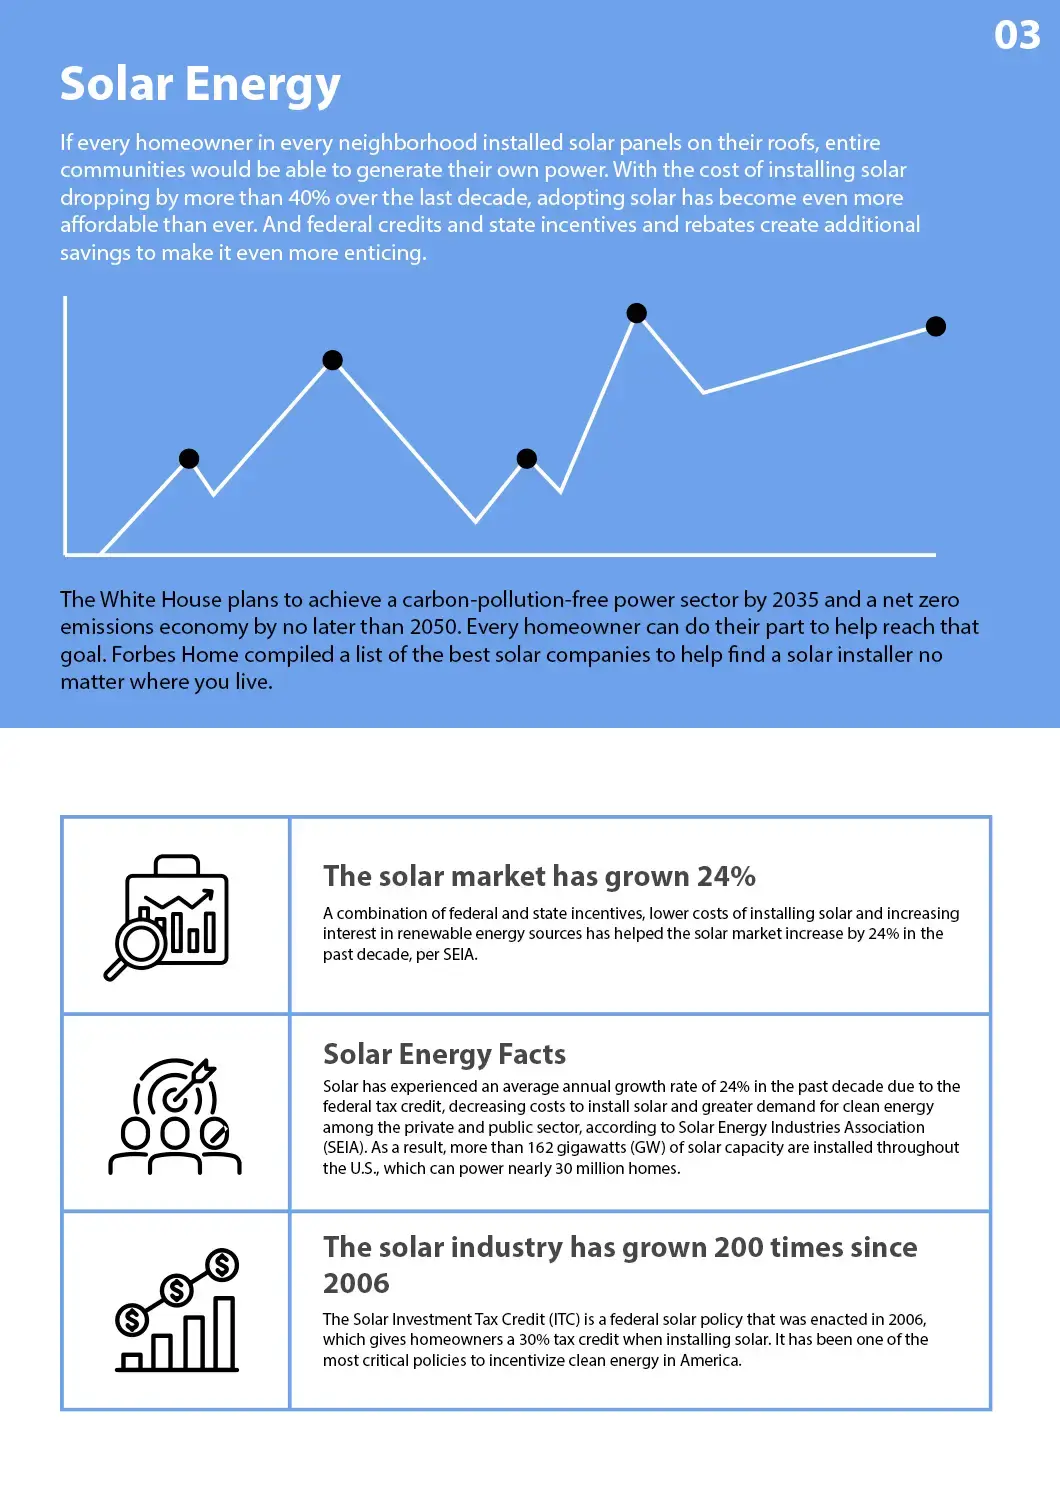
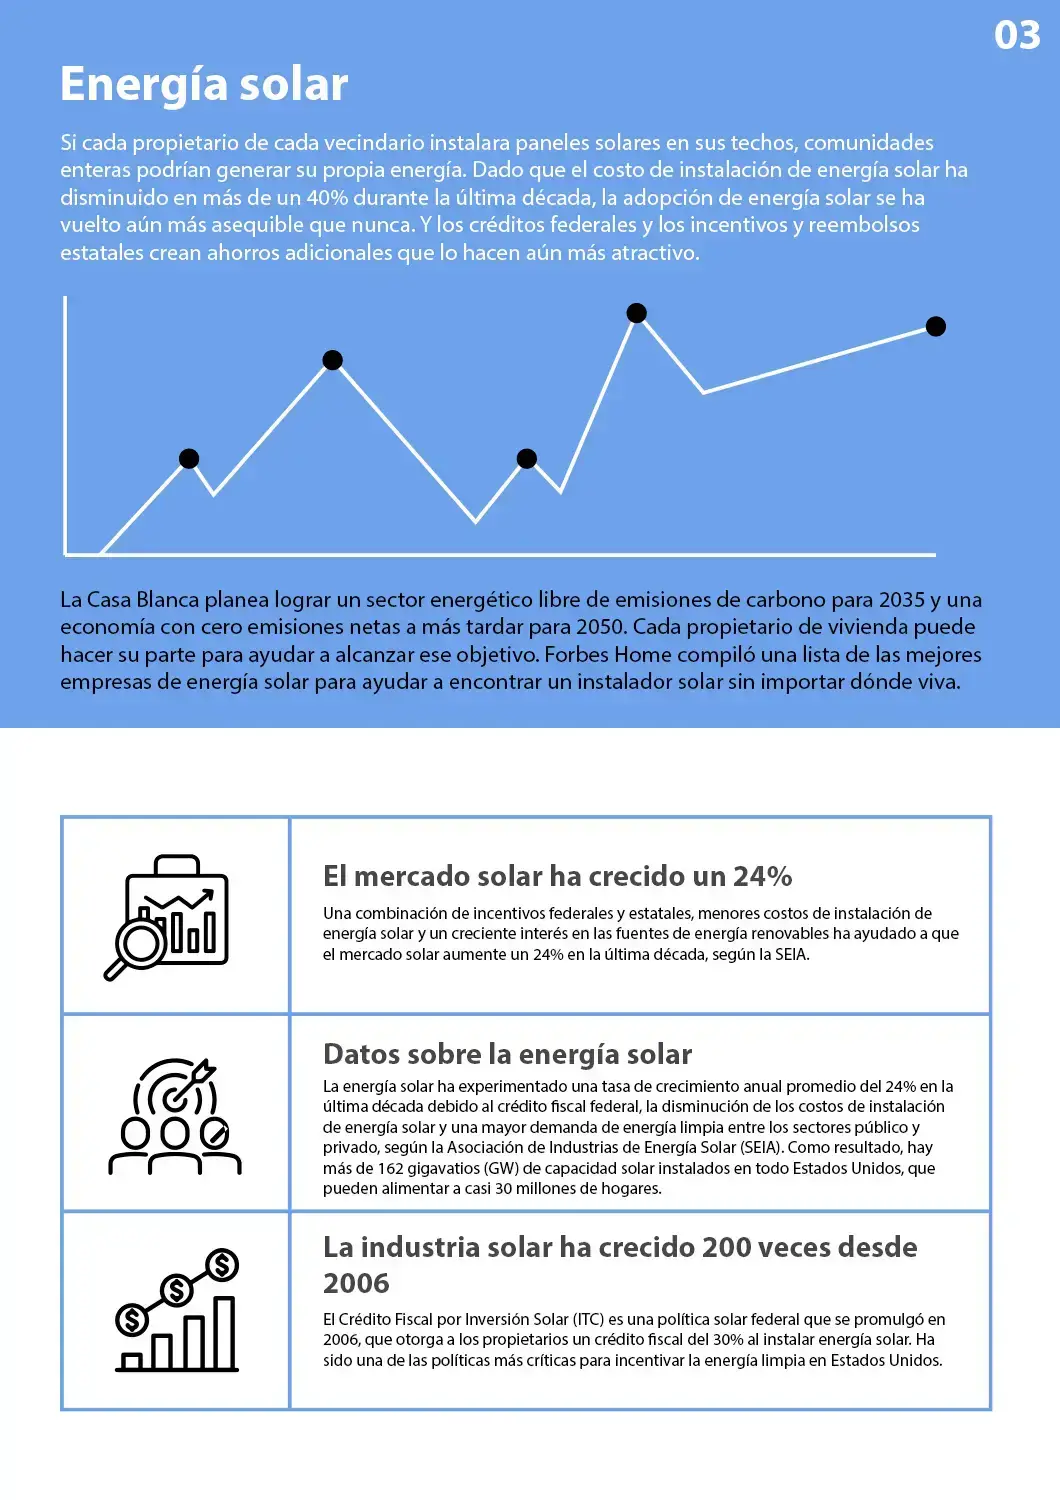
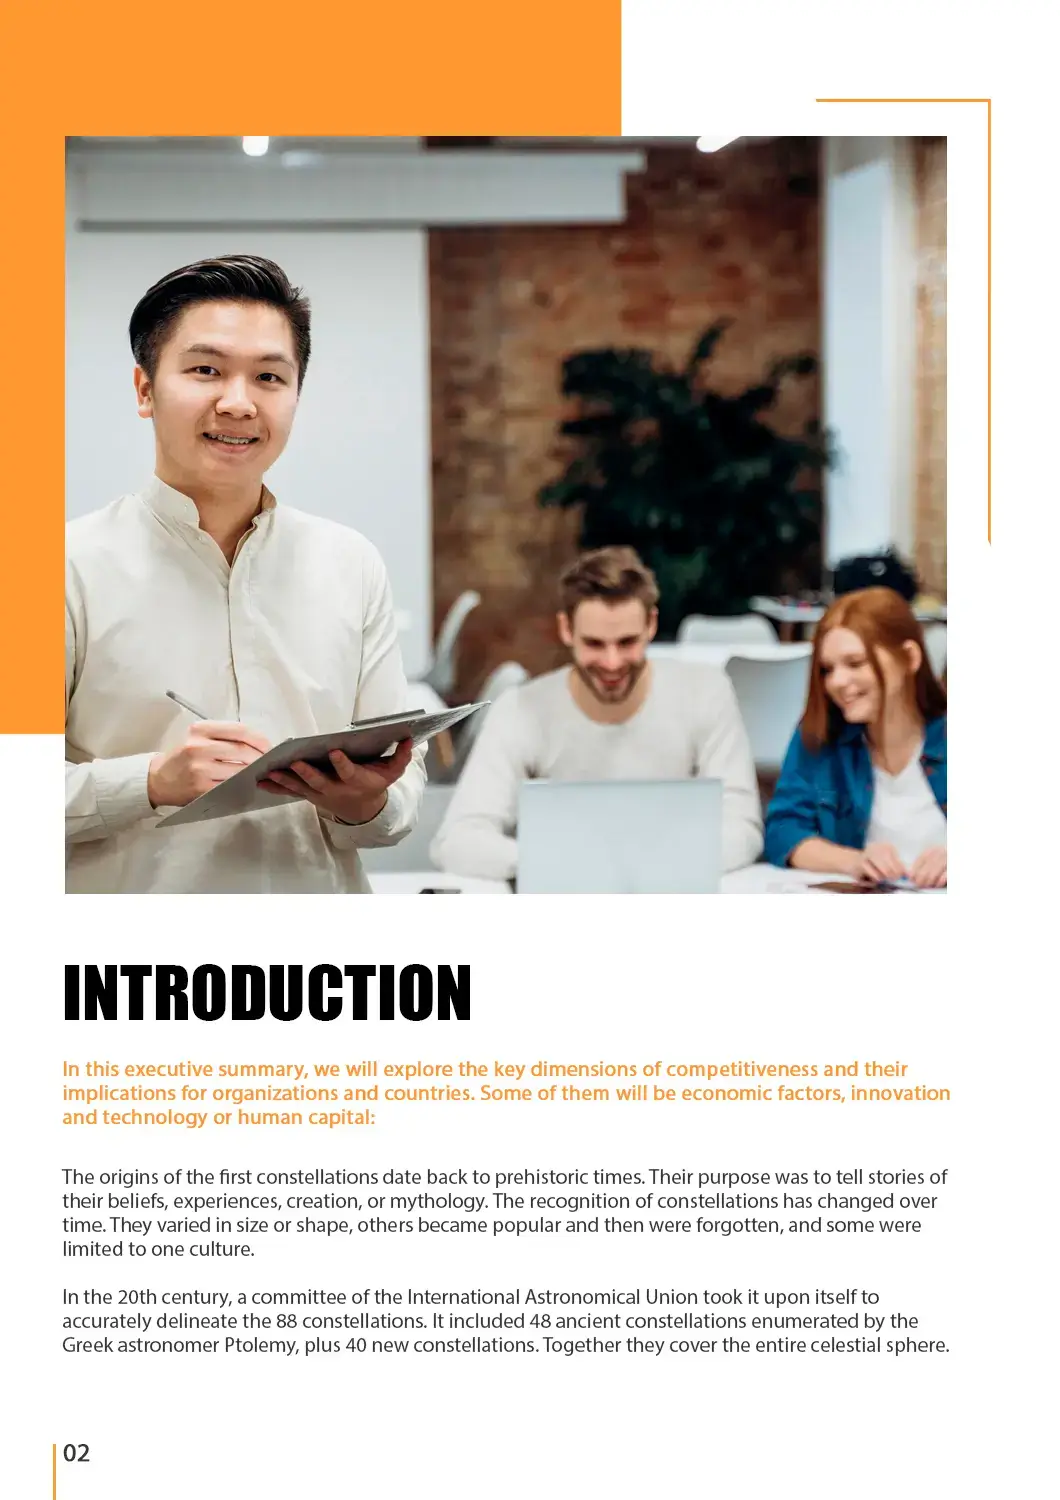
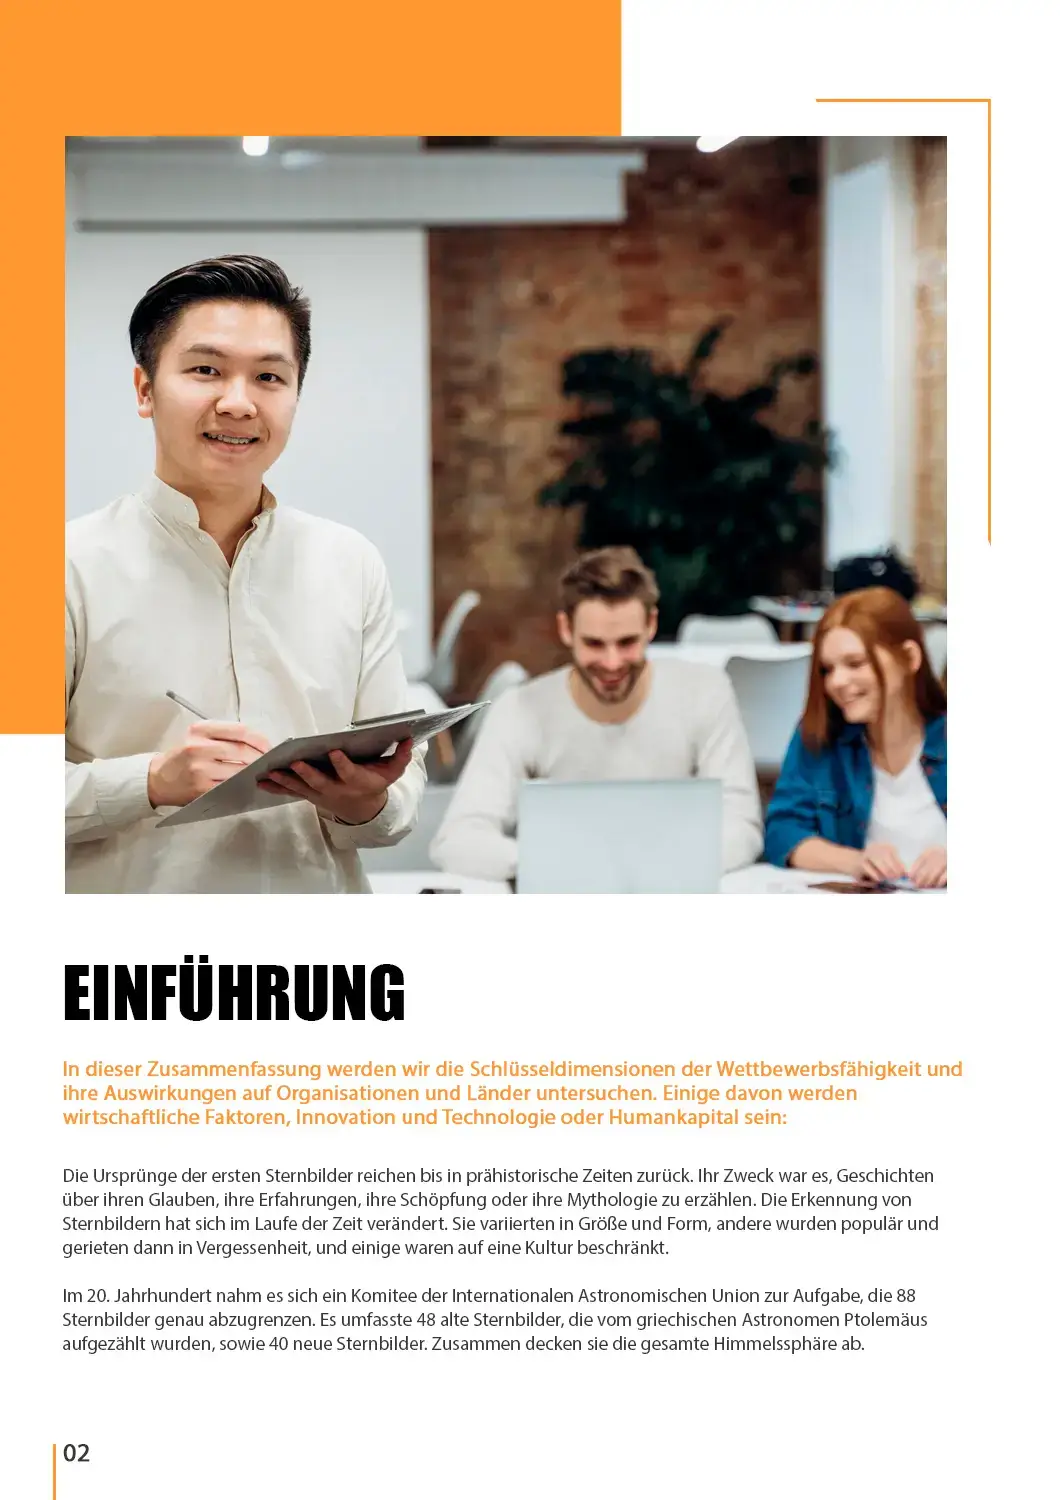
Ніщо тут не було відкрито в електронній таблиці між двома станами.
Переглянути всі приклади перекладів →Робочий процес, що дозволяє уникнути переробки
Локалізація каталогу — це конвеєр, і дорогі помилки трапляються на його кінцях, а не посередині.
- 1
Експортуйте чисто та запишіть діалект
Візьміть експорт безпосередньо з системи, яка володіє даними. Відкрийте його один раз у простому текстовому редакторі, а не в електронній таблиці, і запишіть, який символ розділяє поля та чи взяті значення в лапки.
- 2
Позначте стовпці, які ви не хочете чіпати
Ідентифікатори, ключі, посилання, значення статусу та коди. Якщо експорт дуже широкий, часто швидше скоротити його до стовпців, що містять прозу, і потім знову об'єднати за ключем.
- 3
Завантажте та виберіть мови
Створіть обліковий запис за допомогою електронної пошти, завантажте дані та вкажіть вихідну та цільову мови. Завантаження до 1 ГБ, тому повний каталог обробляється як одне завдання, а не розбивається на частини.
- 4
Спочатку повторно імпортуйте в тестову копію
Завантажте результат у тестове середовище перед виробництвом. Перевірте кількість записів порівняно з оригіналом, перегляньте найдовші перекладені значення на наявність проблем з макетом і підтвердьте, що акцентовані символи пережили подорож.
Запитання від людей з наборами даних
Чи змінюється роздільник, якщо я перекладаю на мову, яка використовує десяткові коми?
Роздільник, який ви завантажили, є роздільником, який ви отримуєте назад. Його зміна означала б переписування структури, а не вмісту, і це зламало б будь-яку програму, яка обробляє дані на іншому кінці. Якщо вам потрібна версія, розділена крапкою з комою, оскільки результат буде відкритий у таблиці на комп'ютері з таким налаштуванням, конвертуйте її після перекладу за допомогою інструменту, який розуміє обидва діалекти.
Як запобігти перекладу кодов продуктів та ідентифікаторів?
Тримайте їх у чітко визначених стовпцях і, де це можливо, надсилайте на обробку лише стовпці з текстом, а потім об'єднуйте за ключем. Значення, які явно є кодами, а не словами, залишаються як є, але найнадійніший варіант — це той, де неоднозначність ніколи не виникає. Ніколи не дозволяйте таблиці торкатися цих стовпців тим часом, оскільки вона переформатує їх незалежно від будь-якого перекладу.
Мої символи з діакритикою повернулися як рядки символів. Що сталося?
Це невідповідність кодування, а не проблема перекладу. Результат майже напевно є правильним Unicode, який читається чимось, що очікує застаріле однобайтове кодування, або навпаки. Відкрийте його в текстовому редакторі, який дозволяє явно вибрати кодування, і підтвердьте, що ви насправді маєте, перш ніж припускати, що щось втрачено. Якщо призначенням є таблиця, маркер порядку байтів на початку зазвичай визначає це.
Що відбувається зі значеннями, які містять коми або розриви рядків?
Вони залишаються в лапках. Будь-яке значення, що містить роздільник, лапку або новий рядок, має бути взято в лапки, а літературна лапка всередині такого значення має бути подвоєна. Оскільки перекладений текст може містити пунктуацію, якої не було в оригіналі, це обрамлення має бути застосовано до результату, а не скопійовано з джерела.
Чи збережуться плейсхолдери та змінні токени?
Вони повинні, і варто перевірити зразок. Токени, такі як знак відсотка, за яким слідує літера, пронумерований слот у фігурних дужках або іменована змінна, є адресами для значень, що вставляються під час виконання. Переклад одного означає, що значення ніколи не досягне екрана, тому перегляньте кілька найдовших рядків інтерфейсу у виводі перед відправкою.
Мої рядки стають набагато довшими німецькою. Чи це має значення тут?
Не для самих даних, які не мають ширини. Це має значення для того, що їх відображає. Розширення від п'ятої до третини порівняно з англійською є нормальним для німецької та російської мов, тоді як китайська та японська зазвичай стискаються. Відсортуйте перекладений стовпець за довжиною та подивіться на крайні значення порівняно з вашим власним макетом, і перевірте будь-який стовпець бази даних з фіксованим лімітом символів.
Який обсяг набору даних я можу надіслати за один раз?
До 1 ГБ або п'яти тисяч сторінок еквівалентного контенту на планах Pro та Business. Це покриває каталоги з сотнями тисяч рядків. Надсилання всього як одного завдання також краще для узгодженості, оскільки термін, який з'являється в рядку 12 і рядку 90 000, обробляється однаково.
За що я плачу при широкому експорті?
Текст, а не сітка. Порожні комірки, числові стовпці та стовпці ідентифікаторів не є прозою. На плані Free кожен файл оплачується окремо за півцента за слово, з мінімумом $0,99, тоді як підписка використовує включені сторінки кожні 30 днів і стягує плату за слово лише після цього. Це дозволяє легко оцінити великий каталог за кількістю слів.
Надішліть експорт, збережіть структуру
Завантажте дані точно так, як їх створила ваша система, виберіть цільову мову та отримайте таблицю з однаковою кількістю стовпців у кожному записі, а ключі залишаться з'єднуваними.
Наші партнери


Пов'язані послуги перекладу
Формати файлів
Інструменти для PDF